RoboHarn-Evo:知识层RSI
一句话判断
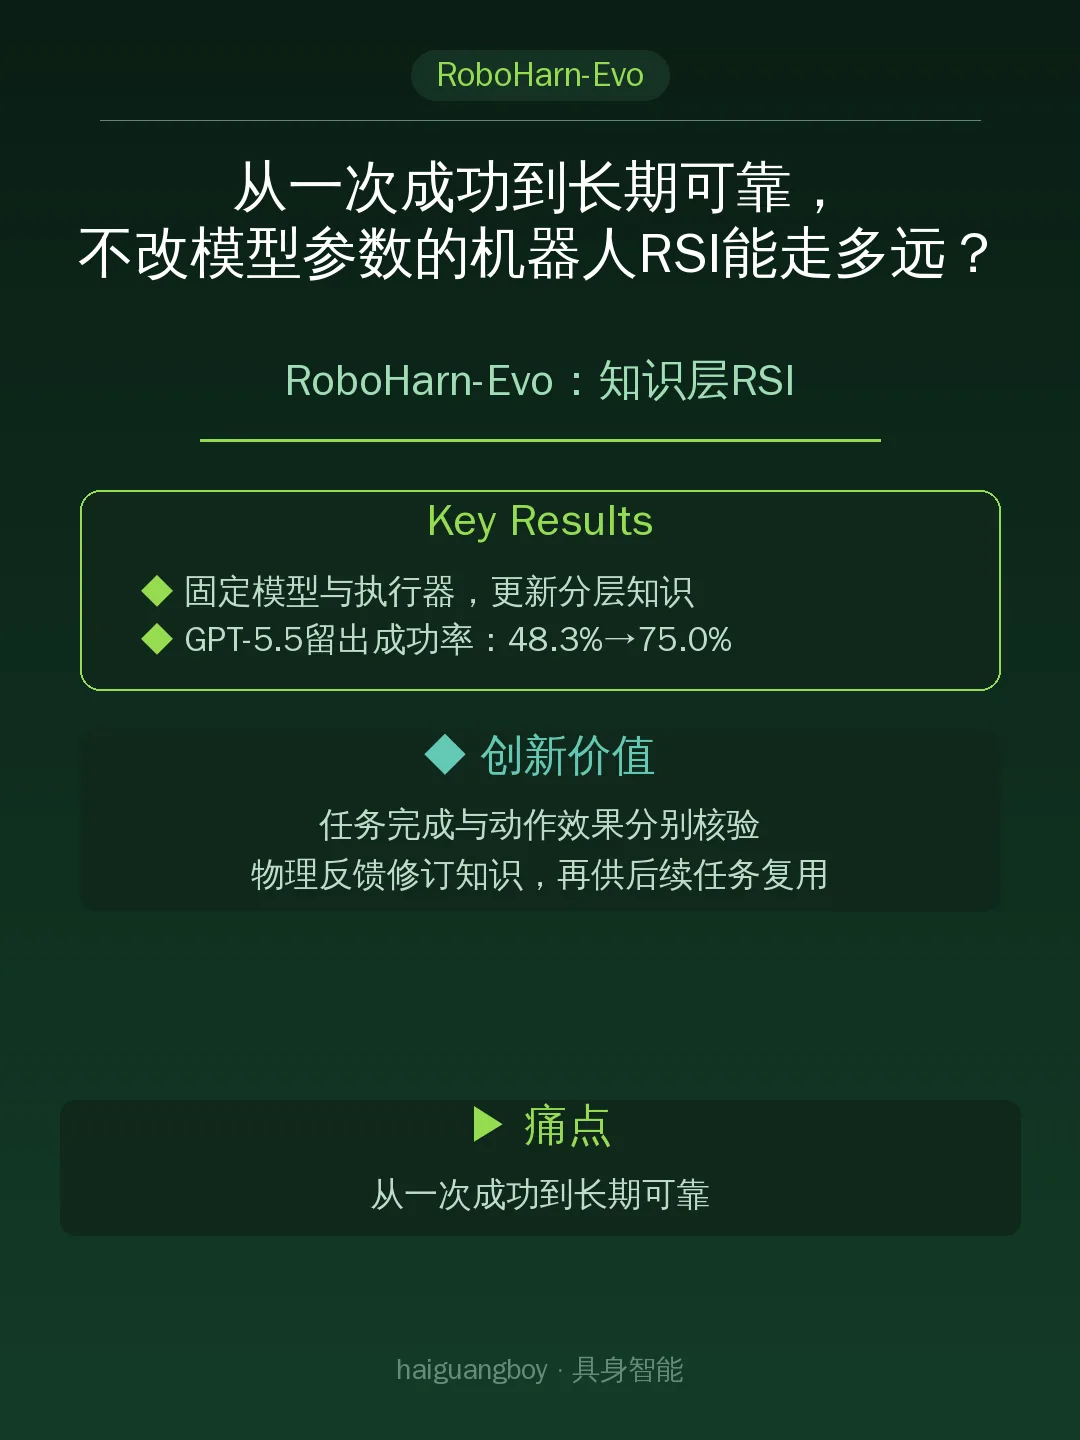
RoboHarn-Evo:知识层RSI
论文解决什么问题
PI联合创始人Chelsea Finn在Actuate 26演讲中强调,机器人真正进入现实服务,需要跨过从一次成功到长期可靠运行的距离。做好一杯咖啡只是开始,还要处理持续工作中的失败与恢复。从真实运行经验中反复改进,是她看好的重要路径。
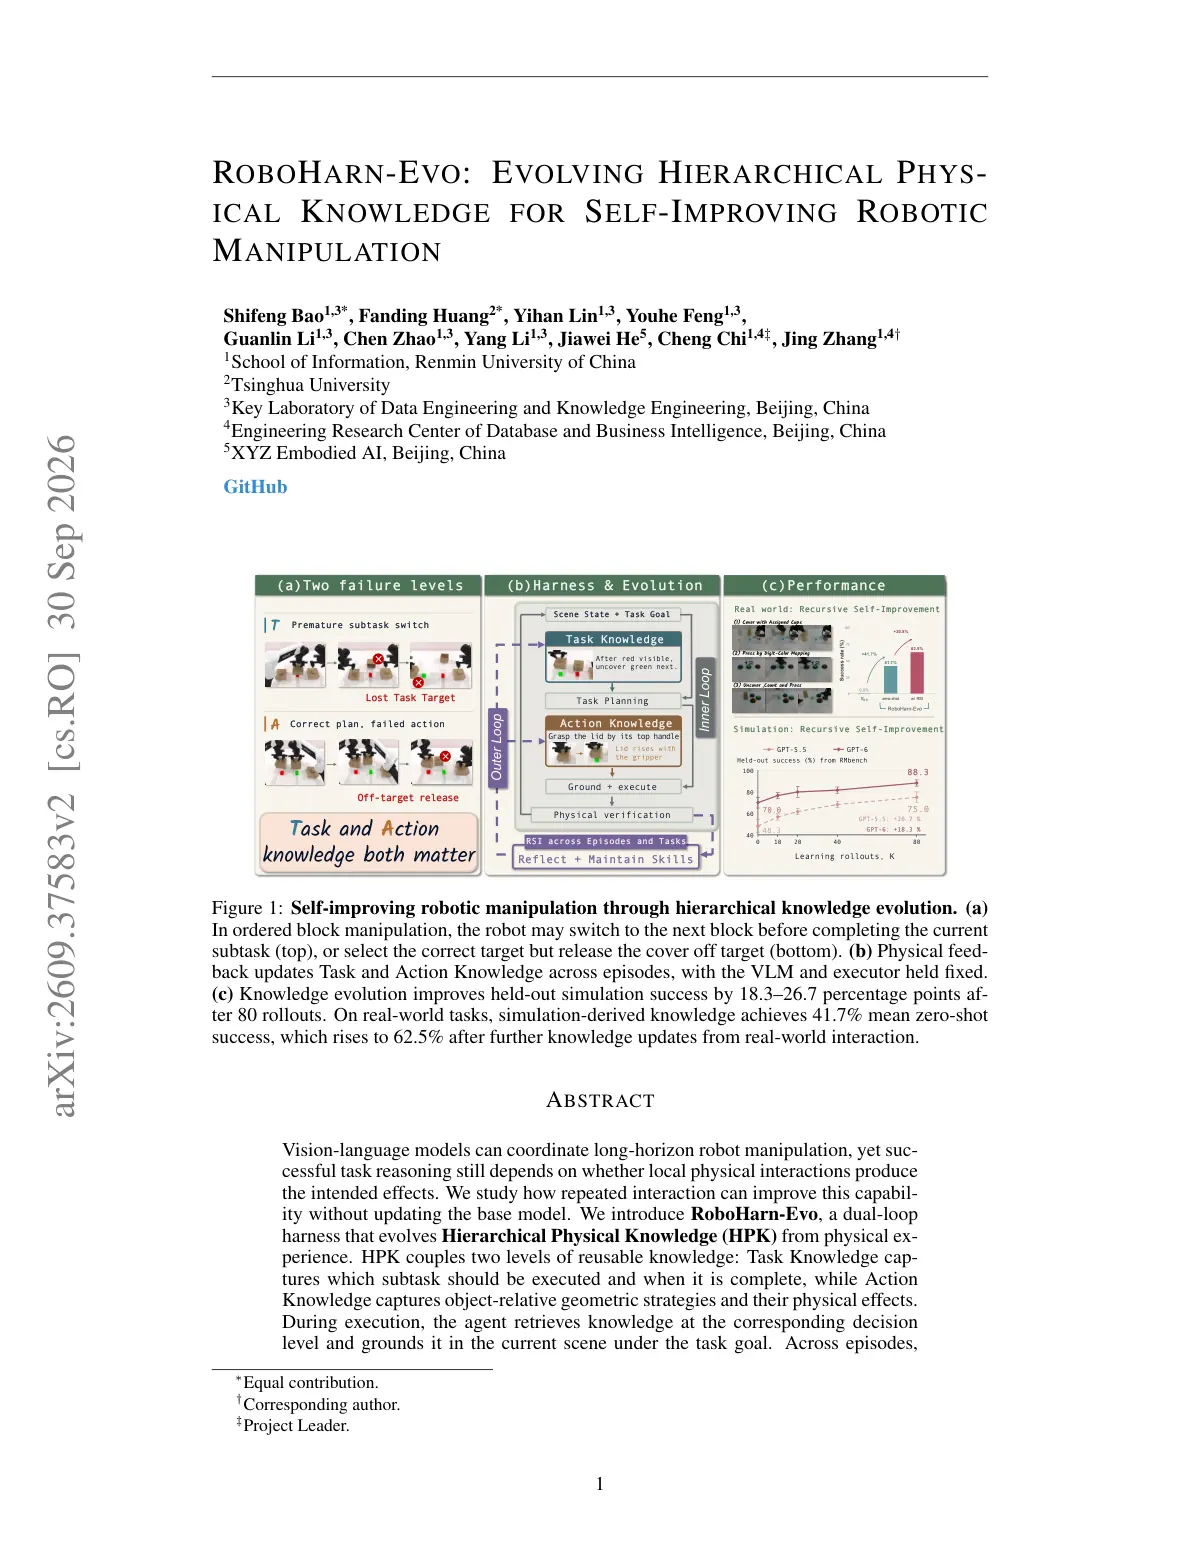
RoboHarn-Evo探索其中一种实现:固定模型与执行器,让交互经验持续修订外部知识。本次经历能否帮助下一次任务,错误经验能否被纠正,是它检验的核心。
核心方法
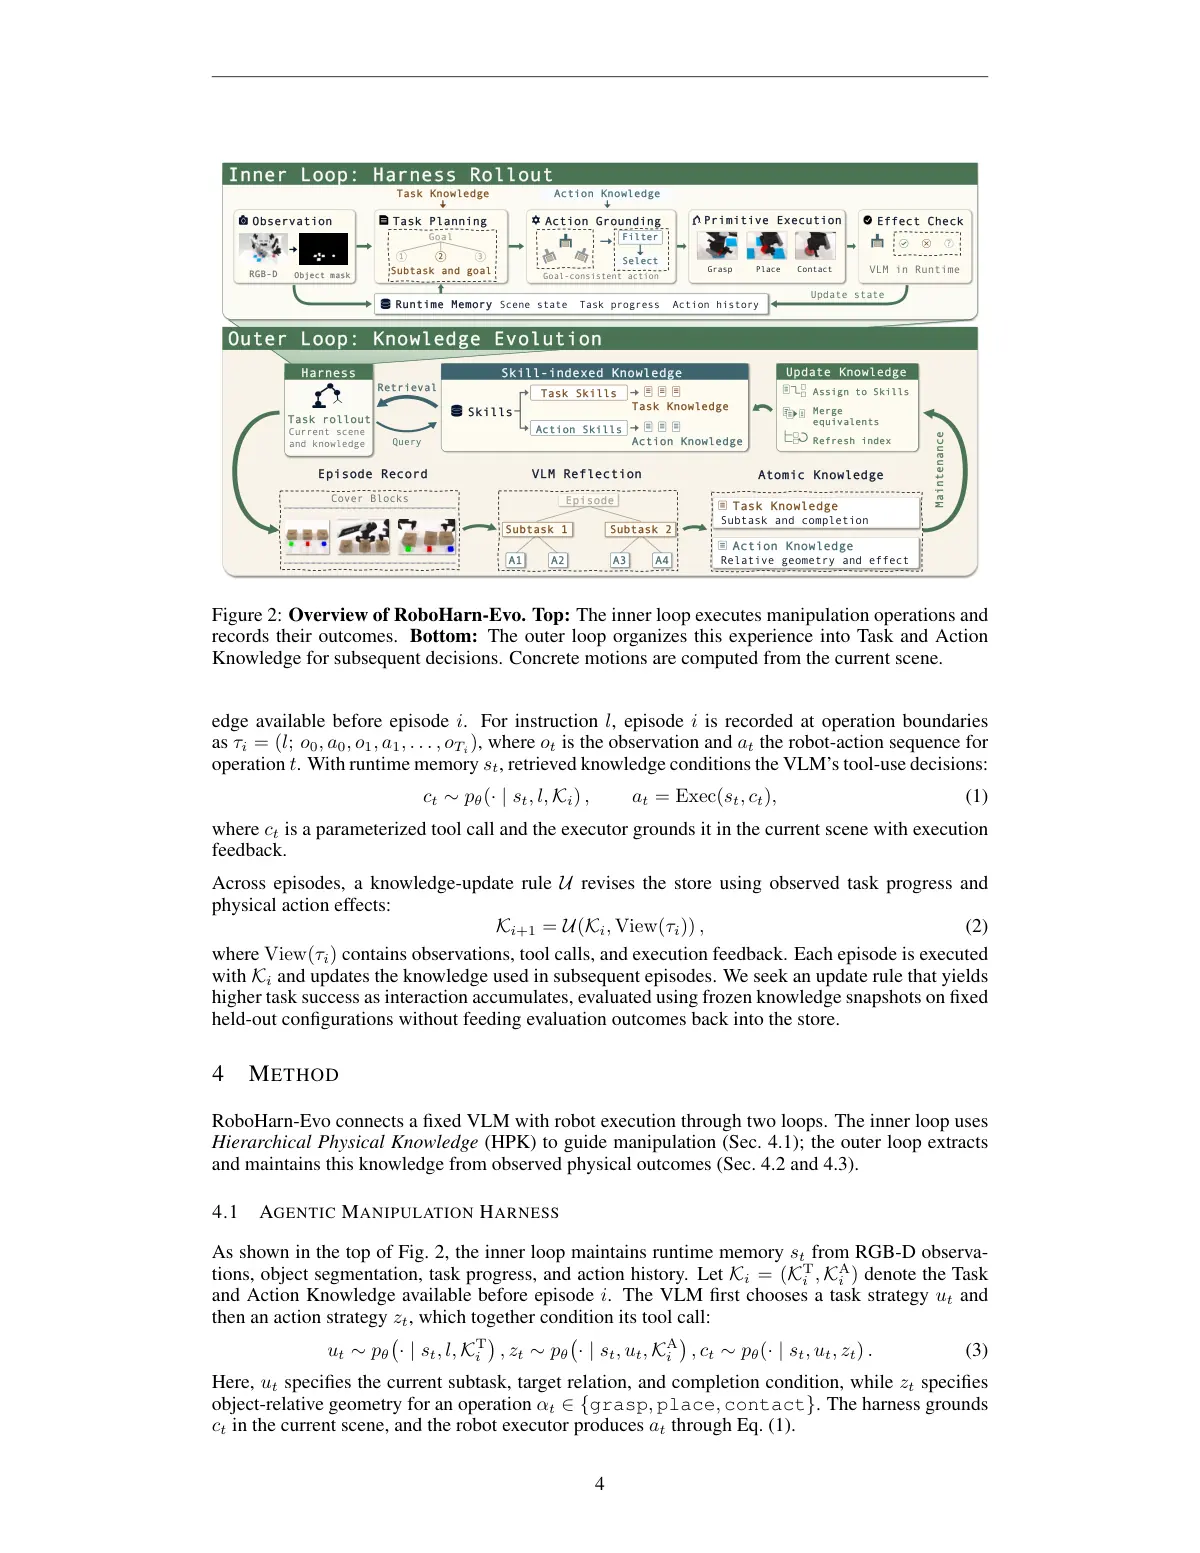
知识指导行动,物理反馈修订知识,再供后续任务复用。但这个循环不能只保存“成功或失败”。
机器人抓起杯子却放偏了,抓取方法可能正确,放置任务仍然失败。整局成败无法告诉系统,该保留哪一步、纠正哪一步。
↳ 任务层记录下一步做什么、何时算完成;动作层记录相对物体的接近方向、交互位置与预期效果。两层分别核验,再关联复用。
↳ 执行时先选子任务,再检索受目标约束的动作策略;具体位姿根据当前场景重算,迁移的是策略与适用条件。
实验结果
只有知识适用、对应策略确实被执行,结果才记为支持、反对或未验证。同一次尝试的后续观察补全原判定,不重复计数。
反证使旧版本退出检索;修订后的策略仍需匹配的执行证据才能重新使用。写出更合理的解释,不等于已经修好了错误。
这篇论文不是什么
⚠️ 还不是长期可靠性的终点
作者称其为RSI,直接证据是知识更新带来的行为提升,尚未单独证明改进能力本身持续增强。模型和执行原语保持固定;错误处理包含修复与停用,知识正确性由外部GPT-6审计,真机验证规模有限。
对机器人 / 世界模型 / VLA 的启发
💡 与其他改进路线对照
PAVE按动作块计算优势,避免把失败任务里的补救动作一起判坏,但每轮仍需重训策略。本篇则把经验收益写入外部知识。
SmoothRL要求优化对齐真正执行的动作,本篇要求证据对应真正执行的策略。共同问题是:失败之后,系统究竟应该改哪里,才能让下一次执行更可靠。
论文关键页