Agile-WAM:轻量视触觉联合预测
一句话判断
Agile-WAM:轻量视触觉联合预测
论文解决什么问题
插头顶在孔边和顺利插入,画面可能很像,接触状态却完全不同。触觉能补上这个缺口,但怎样保留世界模型的预测收益,又把推理开销压下来?
核心方法
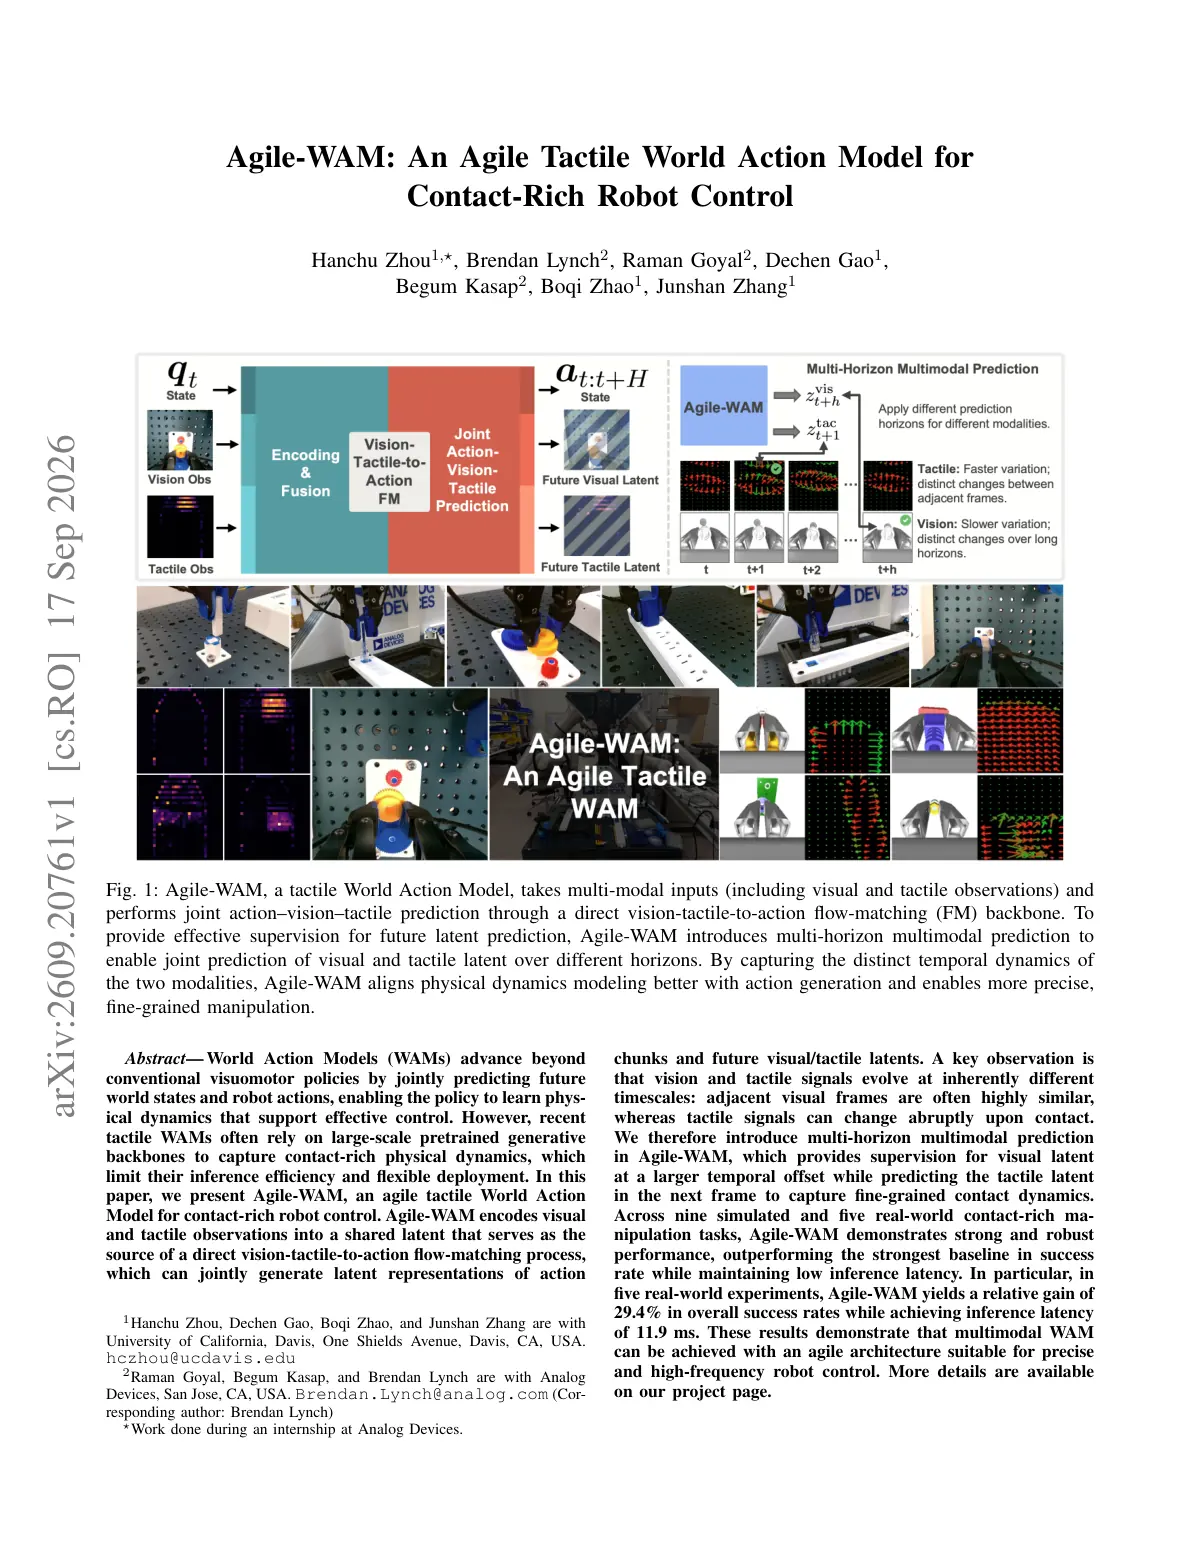
轻量联合预测,视触觉各看不同的未来
↳ ① 当前观测直接驱动动作生成
把视觉、触觉与机器人自身状态编码成共同潜变量,作为流匹配的起点;轻量MLP一次联合生成动作、未来视觉和未来触觉潜变量。观测只编码一次,后续积分不反复注入条件,也不用生成未来视频像素。
↳ ② 视觉看远,触觉看近
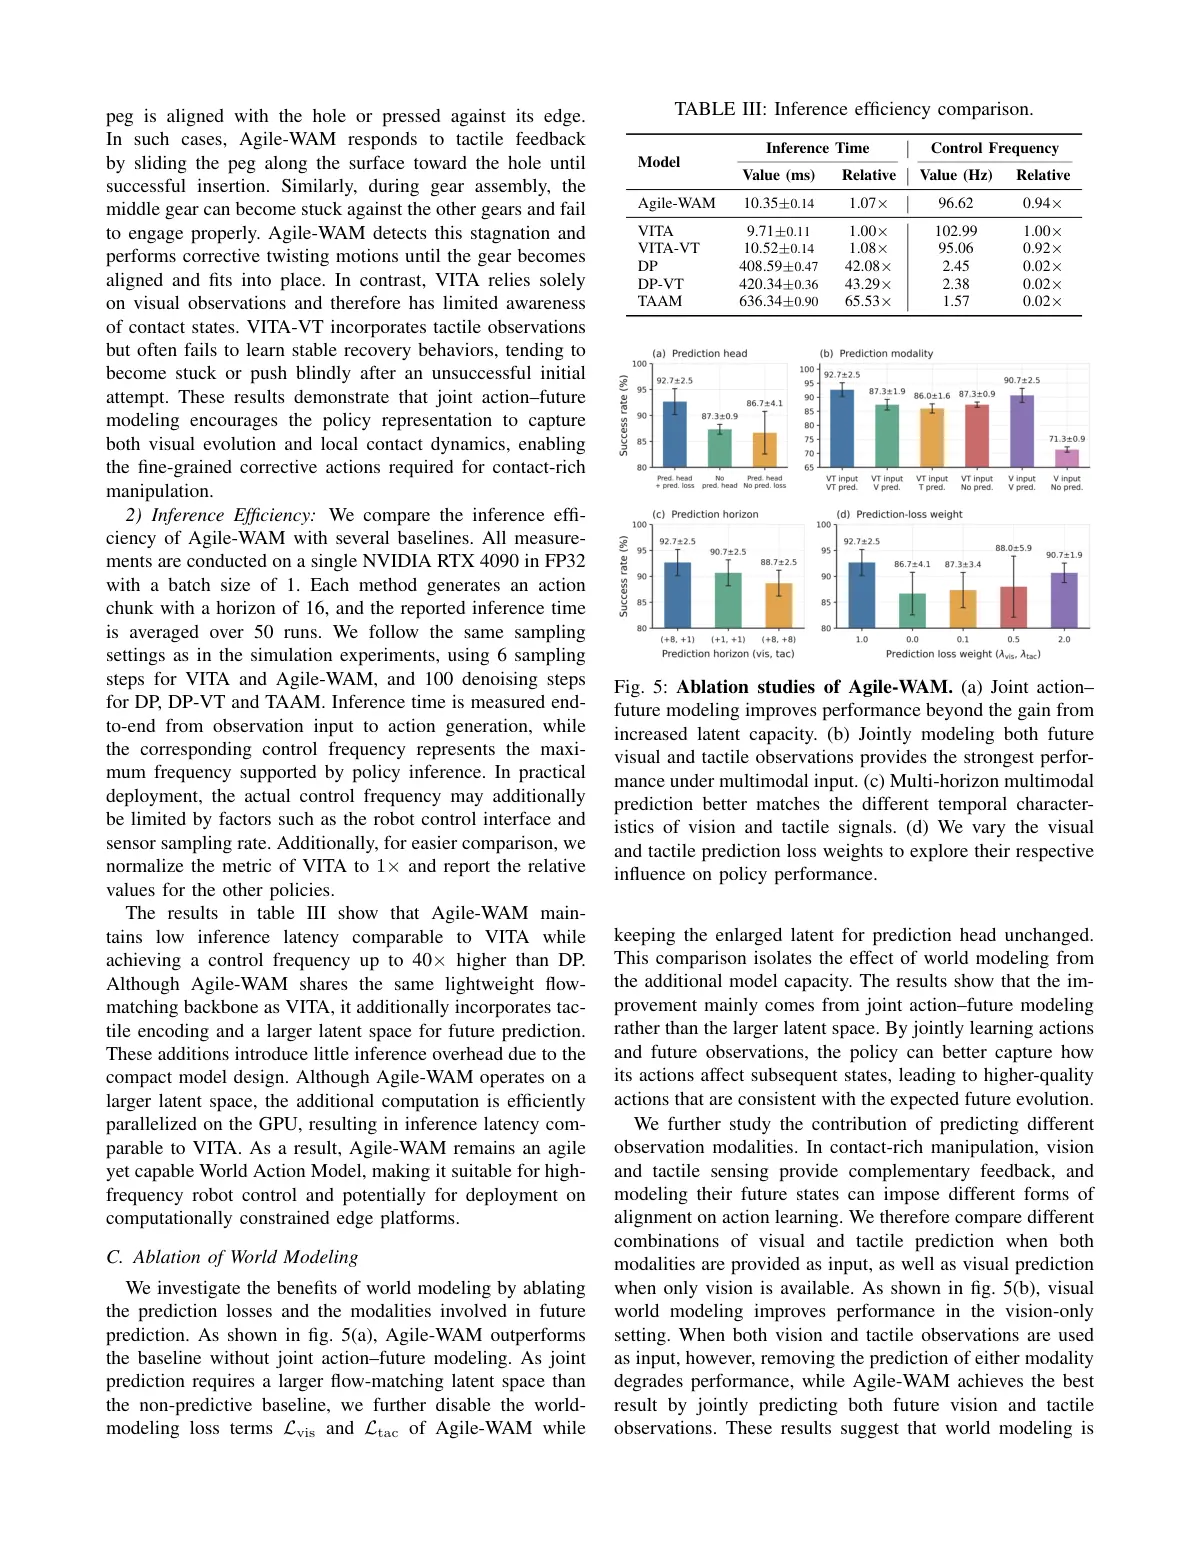
每次生成16步动作,先执行8步再重新规划。视觉预测第8步,避免相邻帧太相似、监督太容易;触觉只预测下一步,保留接触突变。消融中,两种模态都预测下一步、或都预测较远未来,效果都会下降。
↳ ③ 预测还要落实到可执行动作
训练时把生成的动作潜变量解码后直接监督,减少训练与推理的差异。保留同样大的潜空间、只关掉未来预测损失,表现仍下降:收益不能仅用容量增加解释。
实验结果
· 9项仿真、5项真机任务;真机每任务50条示范、20次测试。齿轮装配成功率80%、电源插头插入65%,VITA-VT分别为55%、35%;但插销55%,低于对照的60%,网线插入仅30%。
· RTX4090上生成16步动作约10.35毫秒,接近VITA的9.71毫秒;增加触觉和未来预测后仍保持低延迟。
这篇论文不是什么
⚠️ 边界
约97Hz只是推理能力,真机视觉和触觉采样均为30Hz,部署还需核对传感、推理与执行的完整延迟。纠偏轨迹被主动加入示范,不能说模型凭空学会了纠错;视觉编码器也用了ImageNet预训练。
对机器人 / 世界模型 / VLA 的启发
和T-Rex放在一起看,差别很具体:T-Rex在执行时拆分慢视觉与快触觉修正通路;Agile-WAM在训练时区分视触觉预测时距。两者都重视时间尺度,但“下一步触觉预测”并不等于“高频触觉闭环”。
工程上值得复核的是:换任务、换采样率后,分开设置预测时距是否仍优于统一时距?这决定了它能否成为可复用的方法,而不只是当前配置下的优势。
论文关键页