KODA:人类示范转成人形全身数据
一句话判断
KODA:人类示范转成人形全身数据
论文解决什么问题
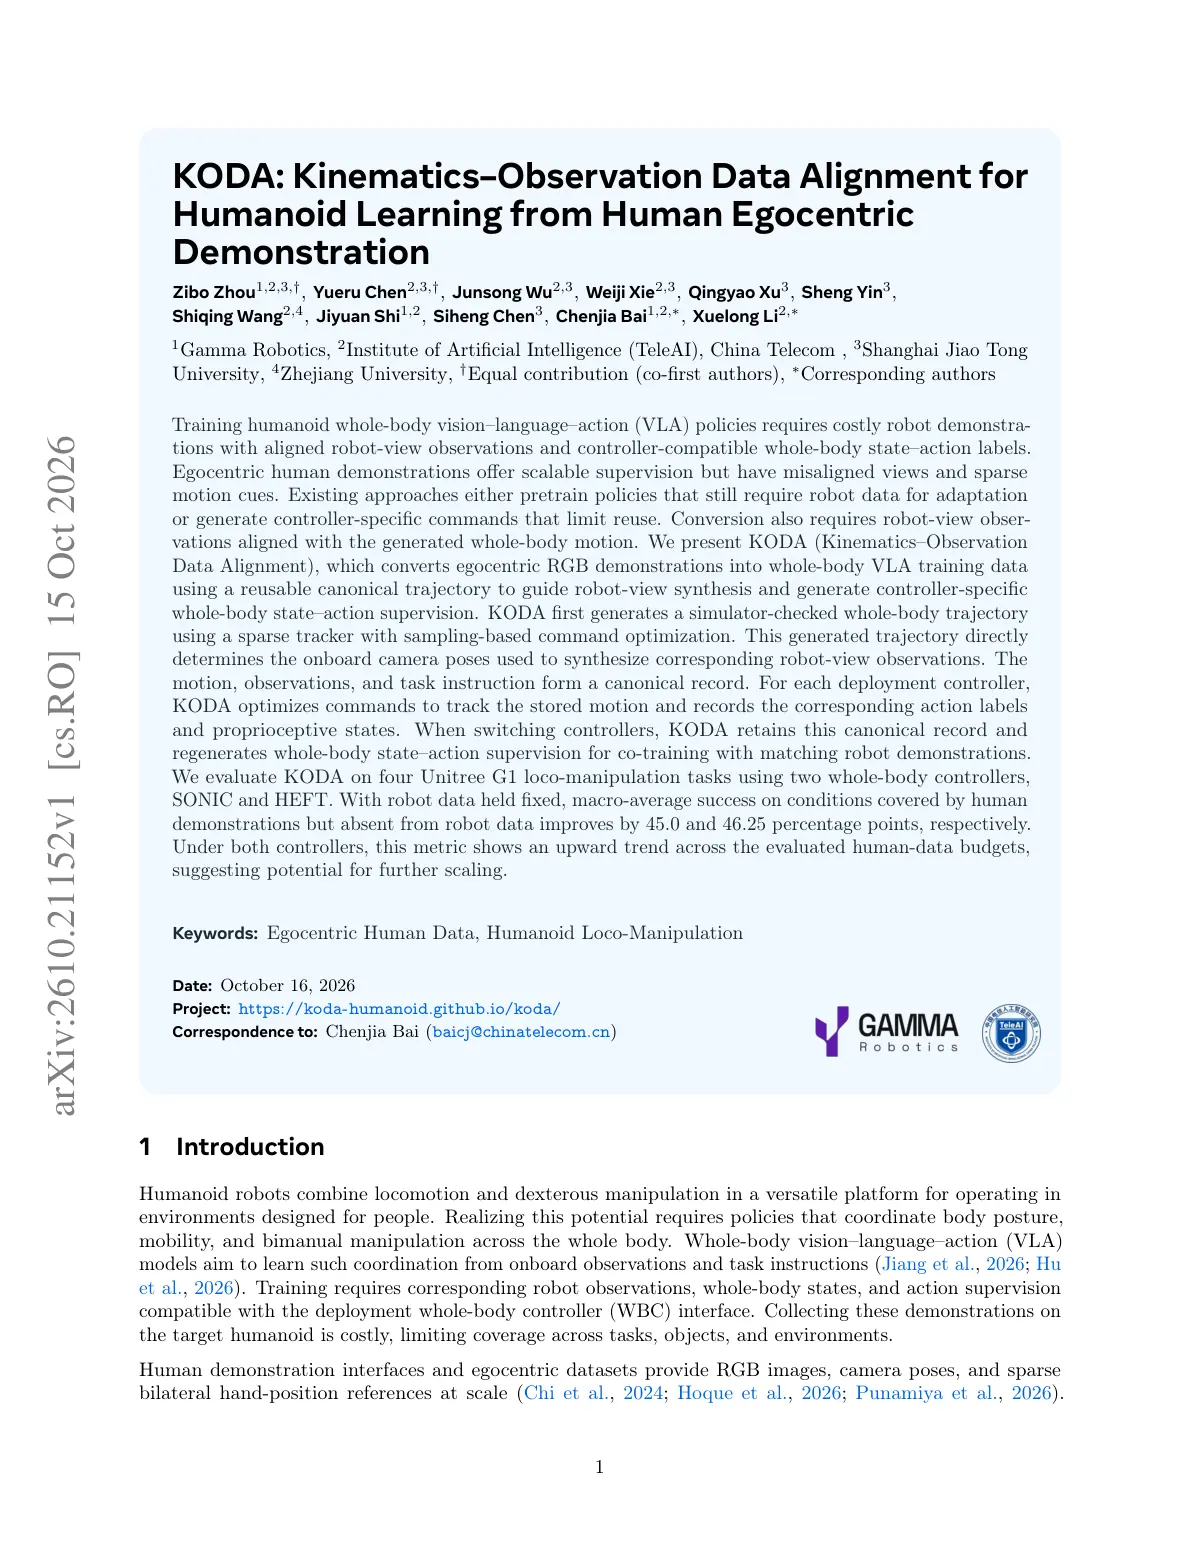
训练人形机器人的全身VLA,需要配套的机载画面、身体状态和控制命令。机器人示范采集昂贵,人类第一视角示范却不能直接拿来训练:人的视角与机器人不同,稀疏手部线索也不是完整全身动作;换一种全身控制器,原来的命令标签还可能不兼容。
核心方法
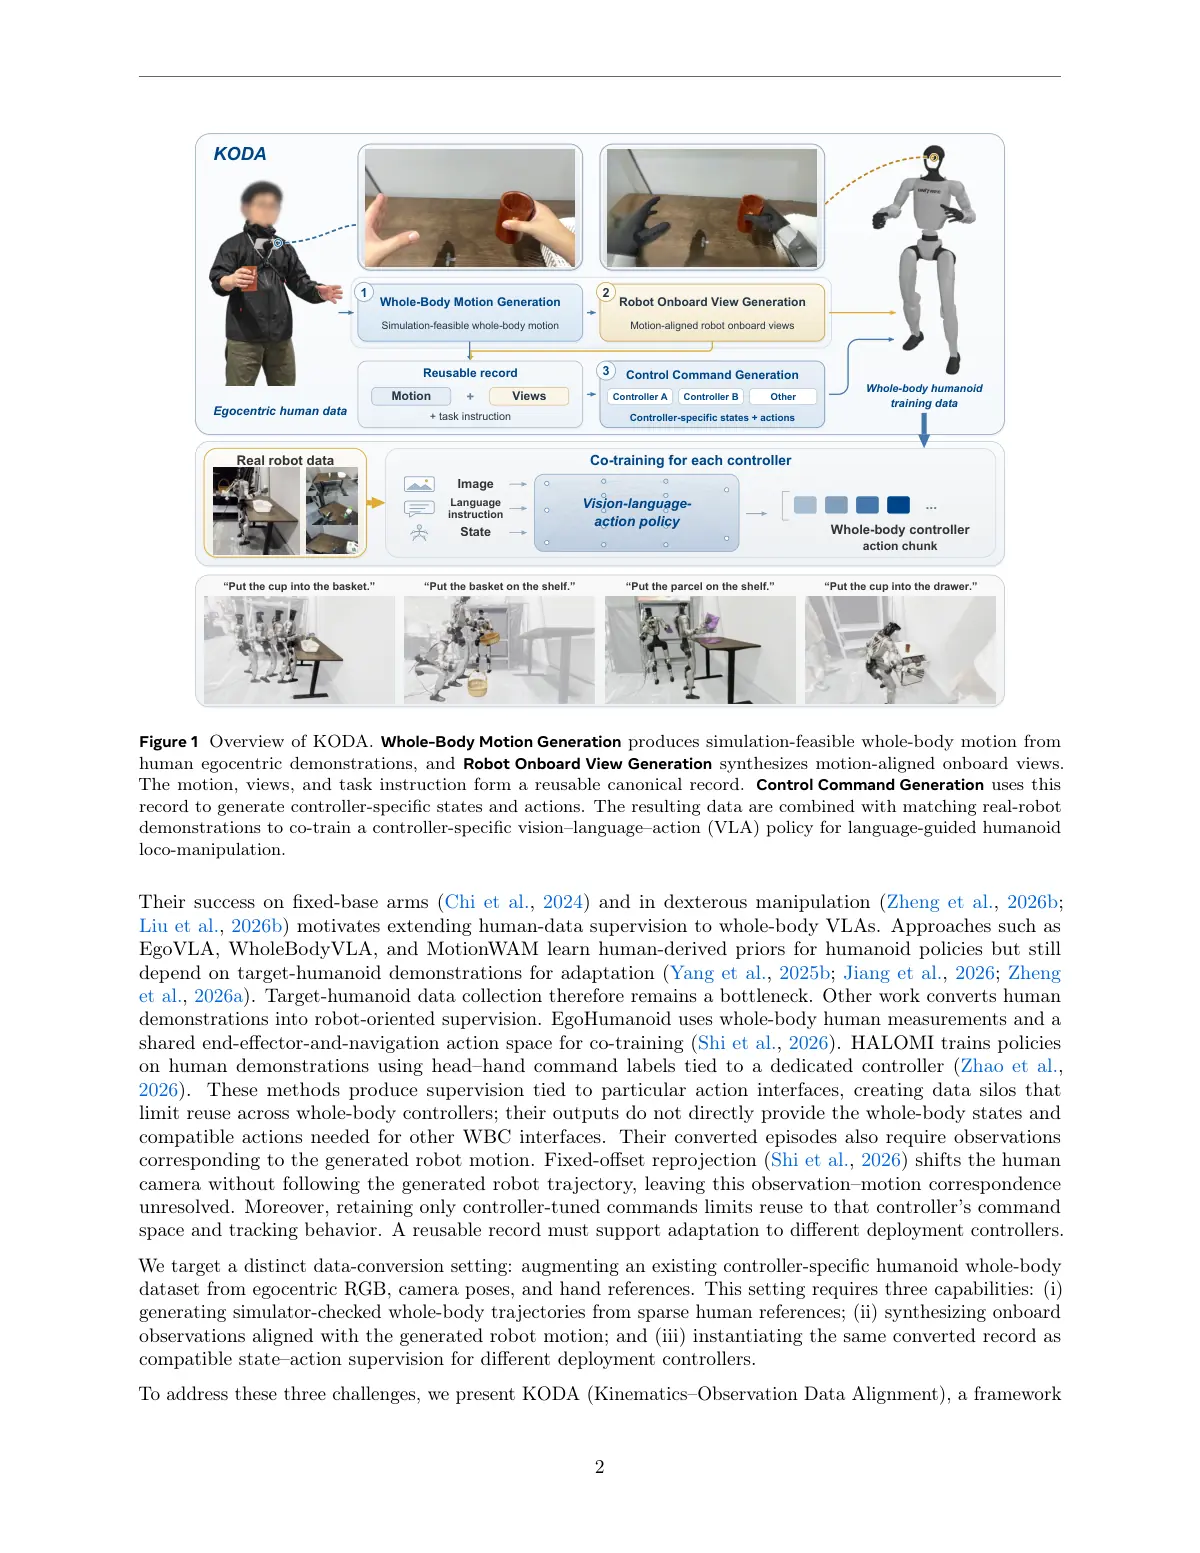
KODA把人类示范转成可复用的“全身轨迹+机器人视角+任务指令”。关键是让同一条生成轨迹,同时决定机器人相机怎样运动,以及部署控制器要跟踪什么,再据此生成训练监督。
↳ ① 从稀疏参考生成全身运动
利用相机与双手参考,重定向手物几何关系,再通过追踪器和仿真中的采样命令优化生成全身轨迹,最后细化手臂,降低腕部跟踪误差。
↳ ② 让机器人画面跟着生成的运动走
由全身轨迹确定机器人相机位姿,重投影场景、移除人臂并渲染机器人,再补全剩余空洞。合成画面对应这段机器人运动,补全只处理外观,不改动作标签。
↳ ③ 换控制器,保留记录、重建监督
切换SONIC或HEFT时,保留规范轨迹和合成画面,重新优化该控制器的命令,并记录仿真实际状态。生成的状态—动作监督,与对应机器人示范共训各自的GR00T N1.7策略。
实验结果
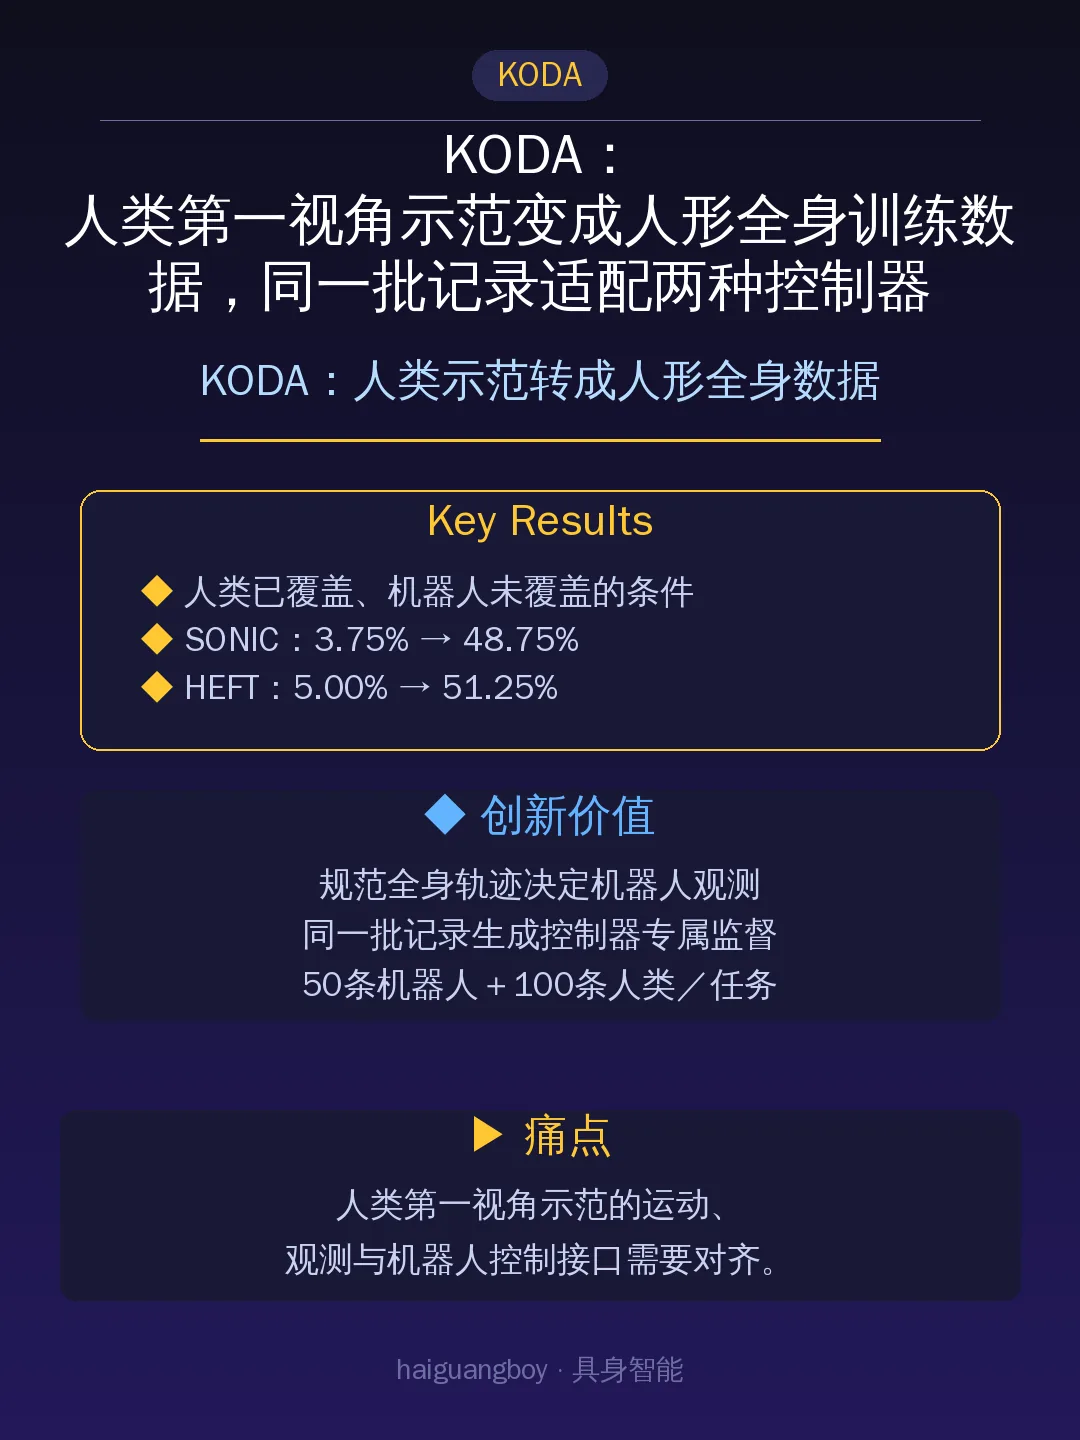
在G1四项移动操作任务中,每任务固定50条机器人示范,再加入100条转换人类示范。在机器人数据未覆盖、但人类数据已覆盖的变化条件下,四任务平均成功率:
· SONIC:3.75%→48.75%。
· HEFT:5.00%→51.25%。
两种控制器下,所测人类数据预算内的Robot-OOD平均成功率均呈上升趋势。
这篇论文不是什么
⚠️ 代价与边界
本次400段人类示范均含手机实测深度,不能等同任意纯RGB视频。跨控制器验证仍在同一G1上,需要重新生成监督并分别训练策略。每配置只训练一次,每任务每条件20次真机试验;扩量趋势尚不足以确立scaling law。
对机器人 / 世界模型 / VLA 的启发
💡 工程启发
监督不匹配也可能负迁移:SONIC加入未做命令优化的转换数据后,已覆盖条件成功率为48.75%,低于仅用机器人数据的62.5%。
与WholeBodyWAM的跨控制器结果对照,数据可复用和策略免适配是两层问题。KODA把复用放在运动与观测记录,把接口差异留给监督生成。后续要看:更多控制器下,能否保住任务收益并减少重复转换成本。
论文关键页