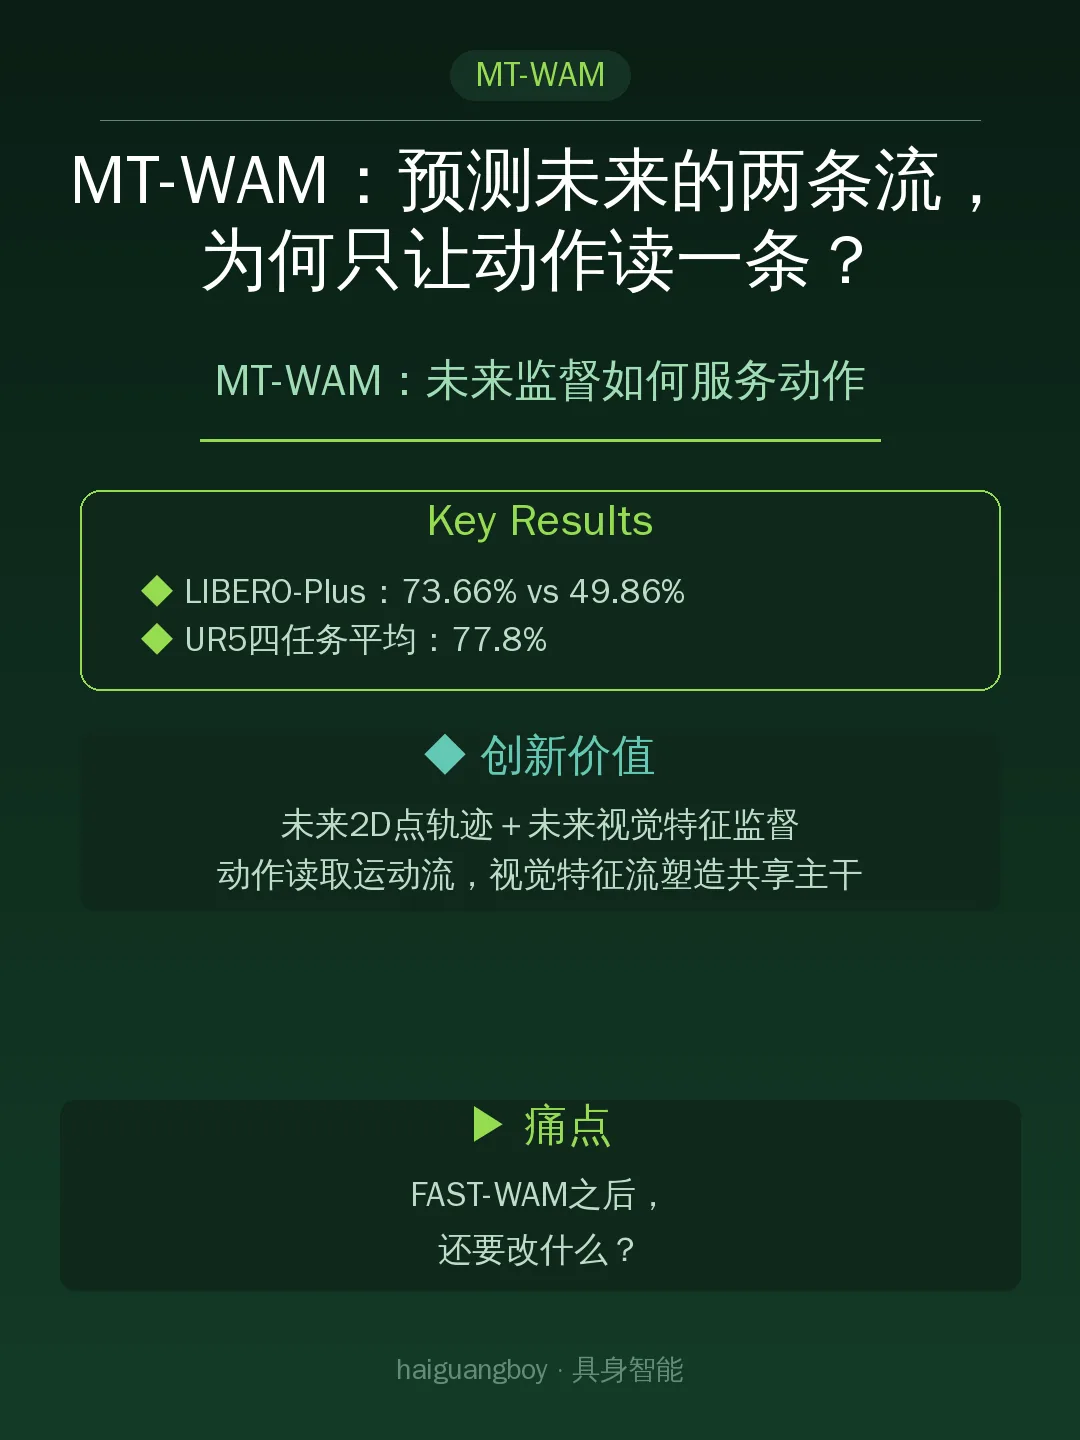
MT-WAM:未来监督如何服务动作
一句话判断
MT-WAM:未来监督如何服务动作
论文解决什么问题
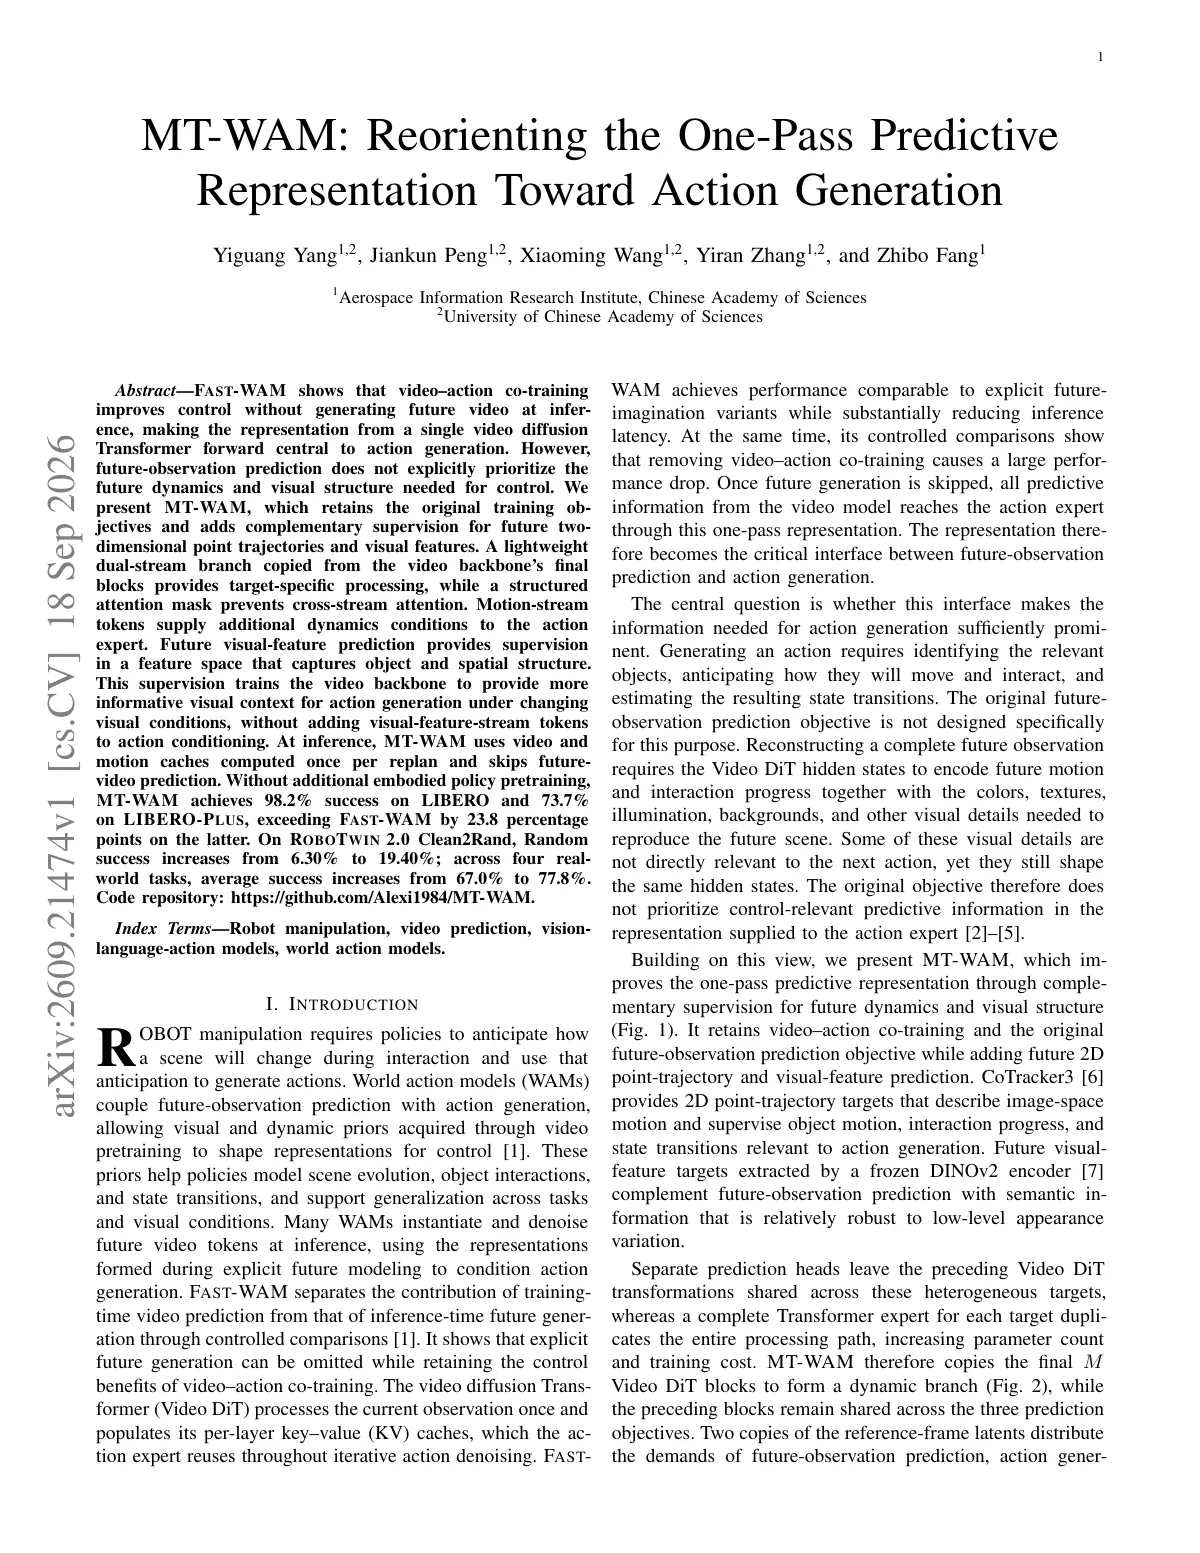
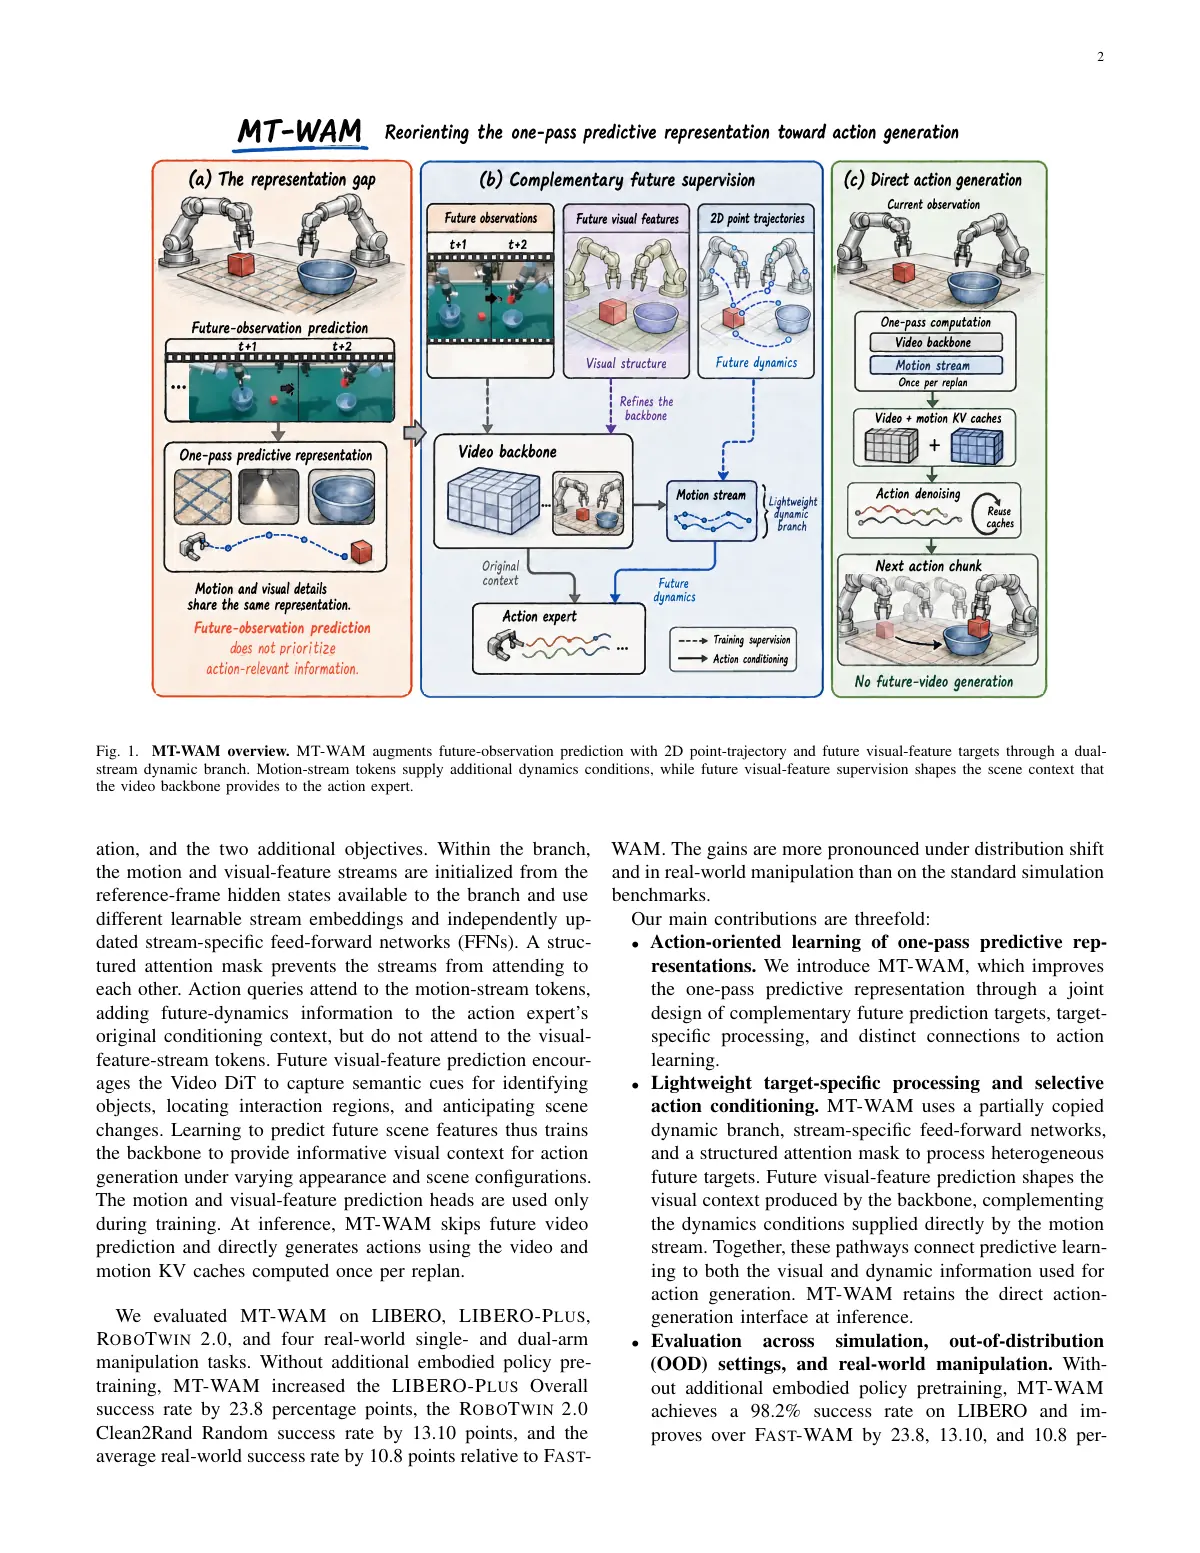
FAST-WAM已能跳过推理时的未来视频生成。但训练时重建未来,仍会同时学到运动、纹理和背景,不一定优先突出动作需要的信息。MT-WAM沿用这条快速控制路径,重点改的是动作专家读取的表征。
核心方法
↳ 保留视频—动作联合训练,新增CoTracker3的未来2D点轨迹与冻结DINOv2的未来视觉特征监督;复制视频主干末端,形成运动流和视觉特征流,前部共享。
↳ 动作直接读取当前帧与运动token;视觉特征流不让动作直接读取,只通过训练塑造共享主干。学什么、让动作看什么,被拆成两个设计问题。
↳ 部署时跳过未来视频与辅助预测头,但保留运动分支。每次重规划运行一次主干与运动分支,缓存供动作多步去噪复用;“一次前向”不等于动作一步生成。
实验结果
保持参数量与目标不变,只让动作额外读取视觉特征流,LIBERO-Plus成功率从73.7%降到70.9%;把视觉特征流整个删掉,又降到68.8%。它对训练有用,却不适合在这个设置下直接供动作读取。
这篇论文不是什么
⚠️ 工程代价与边界
同一RTX PRO 6000上延迟仅增5.79%,FLOPs却增37.63%。2D点轨迹不代表掌握3D接触动力学;现有消融也未完全拆开额外容量与辅助监督各自的贡献。
对机器人 / 世界模型 / VLA 的启发
💡 放到相关工作里看
TacWAM把未来触觉用于监督,并在嵌套消融中发现,逐步放开信息交互会损害控制;这与MT-WAM的非对称分工呼应。
但OpenWAM发现,切断动作对世界特征的访问会掉约5分。两者并非直接互相否定:世界流与辅助视觉特征流不是同一种信号,MT-WAM也保留了动作对运动流的读取。工程上真正该逐项验证的是:哪个目标改善表征,哪条信息通路改善控制。
论文关键页