不装腕相机,VLA成功率反而更高
一句话判断
不装腕相机,VLA成功率反而更高
论文解决什么问题
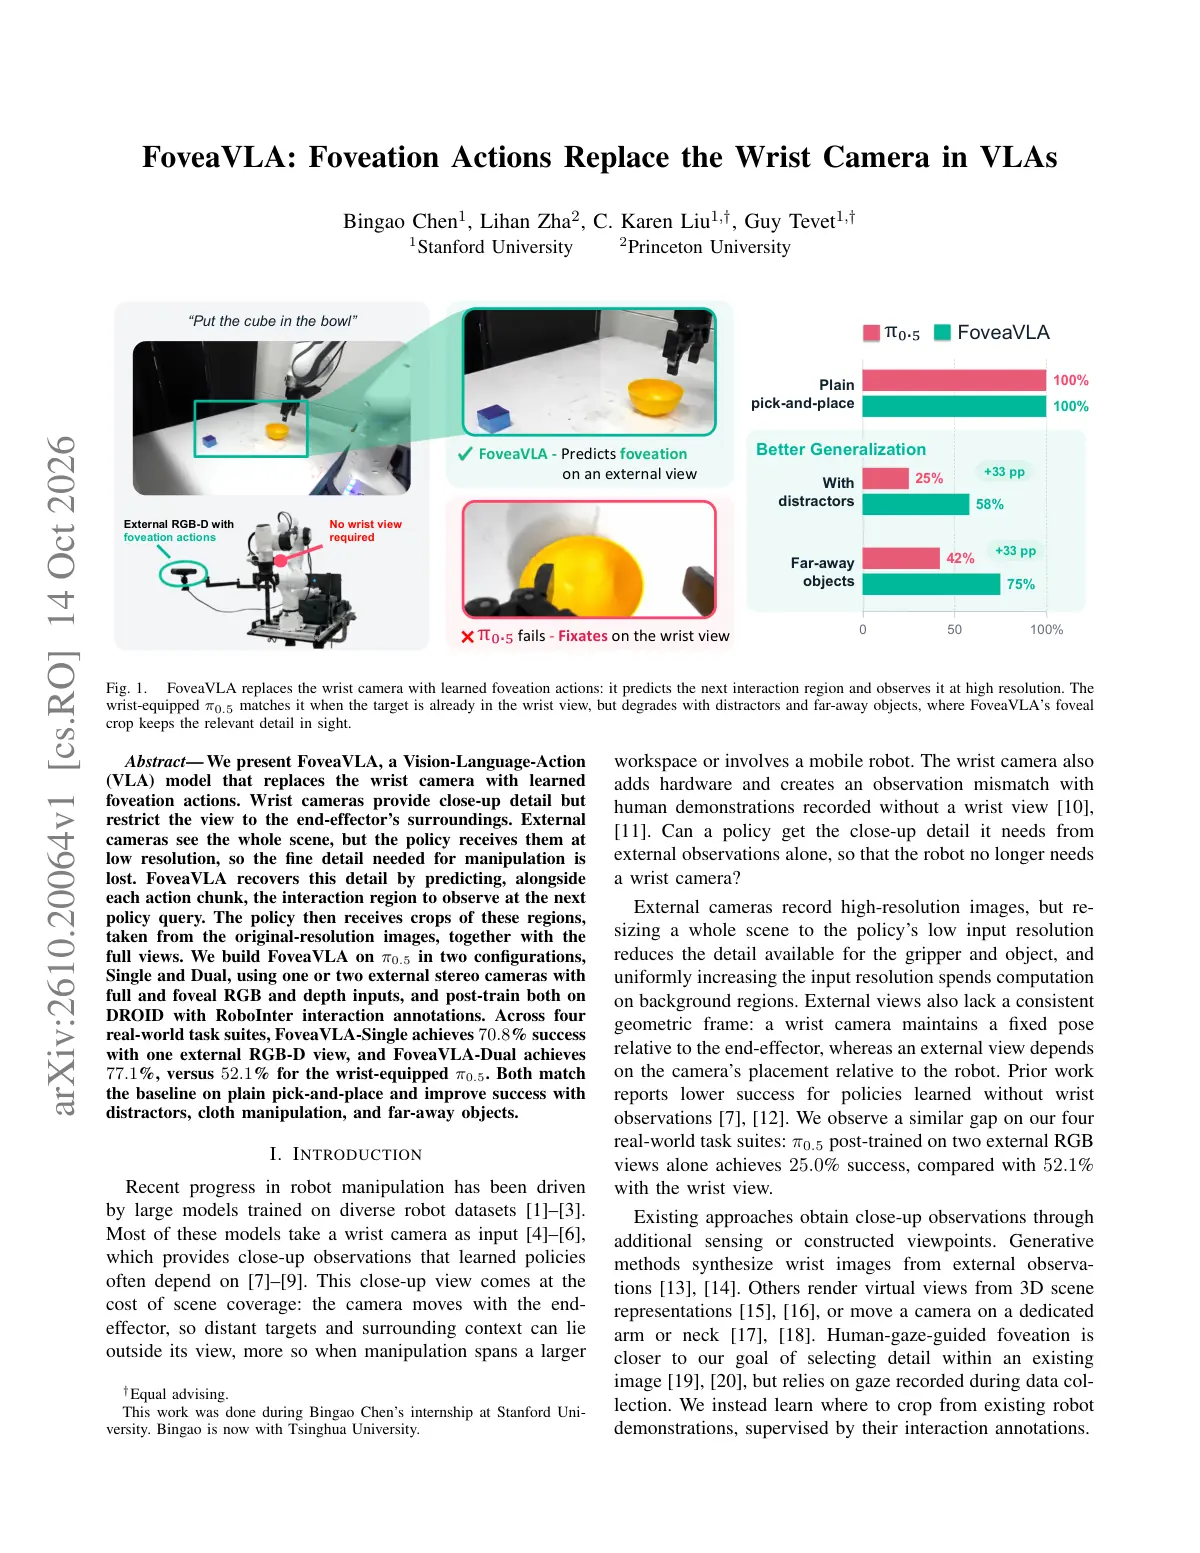
腕相机能看清夹爪附近,却容易漏掉远处目标和周围布局。外部相机看得全,但整张图缩到模型输入尺寸后,操作细节又被压小。
FoveaVLA在π0.5上后训练,让策略同时学习“怎么动”和“下一次看哪里”,用外部视角的全景与局部细节完成操作。
核心方法
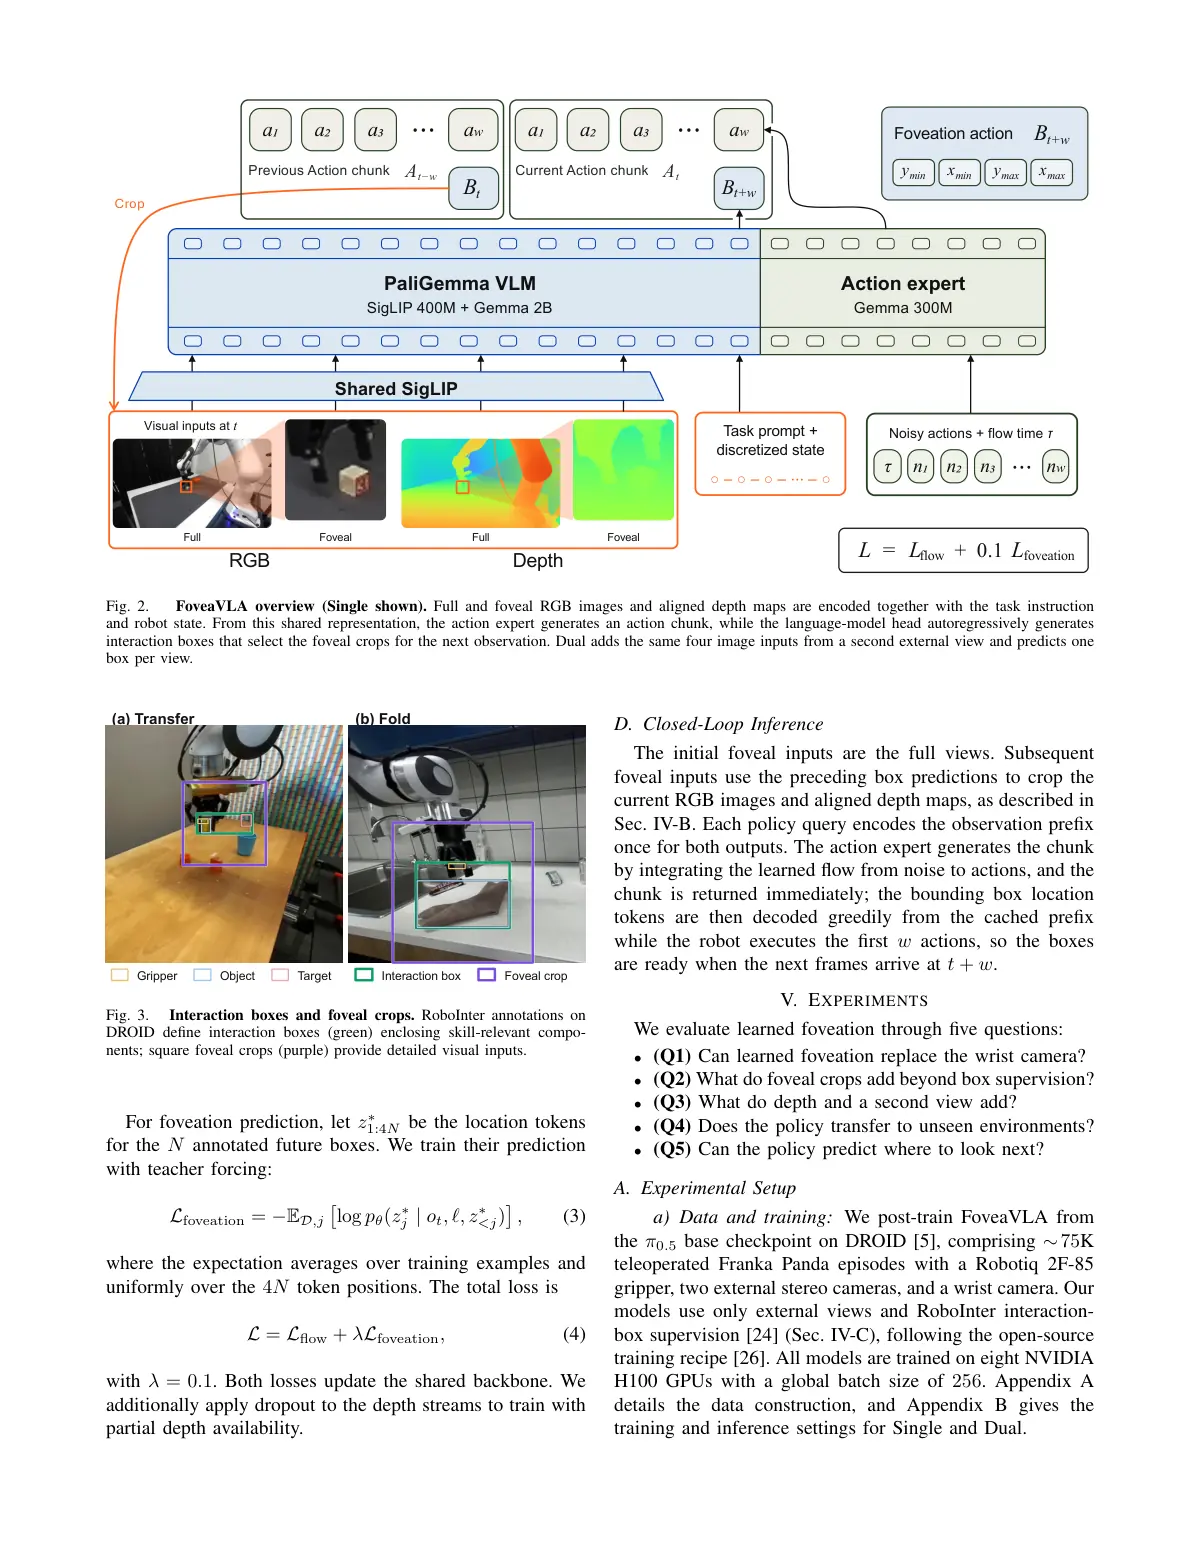
每次查询预测16步动作,执行前8步;同时预测下一次查询时的交互区域。
↳ 等新图像到达,用之前预测的框从原分辨率图像裁出局部,再缩放到224×224。
↳ 全景保留布局,局部提供细节;RGB与深度采用相同裁剪。
↳ 动作与框共享观测表征,但输出分支隔离。框通过改变下一次观测影响后续动作,不是先把当前框喂给当前动作头。
区域监督来自DROID上的RoboInter交互标注,不需要采集人类眼动。
实验结果
四套真机任务、每套12次:
· 带腕相机π0.5:52.1%。
· 一个外部RGB-D视角:70.8%。
· 两个外部RGB-D视角:77.1%。
普通取放均为100%,增益出现在干扰物、布料和远物体任务。
更关键的是消融:双外部RGB仅全图25.0%,增加框监督31.3%,真正输入局部图后66.7%。知道该看哪里,还要让模型实际看到更多细节。
这篇论文不是什么
⚠️ 少一只腕相机,不等于零成本
RTX 5080上,Single动作查询约125ms,框解码约50ms。框解码与动作执行重叠,论文设置下无需等新帧到达后再定位,但计算并未消失。
真机每方法仅48次,不能外推工业可靠性;利用无腕人类视频训练,也仍是展望。
对机器人 / 世界模型 / VLA 的启发
💡 放回预测与控制的技术脉络
MT-WAM提醒:预测任务有用,不意味着预测token都该直接成为动作条件。FoveaVLA提供另一种接法:预测结果改变下一次收集的视觉细节。
值得检验的是,在遮挡、相机位置变化和更大工作空间中,这种“预测—观测—动作”循环能否持续保住收益,而不只是把目标框预测得更准。
论文关键页