VLAW:策略与世界模型共同改进
一句话判断
VLAW:策略与世界模型共同改进
论文解决什么问题
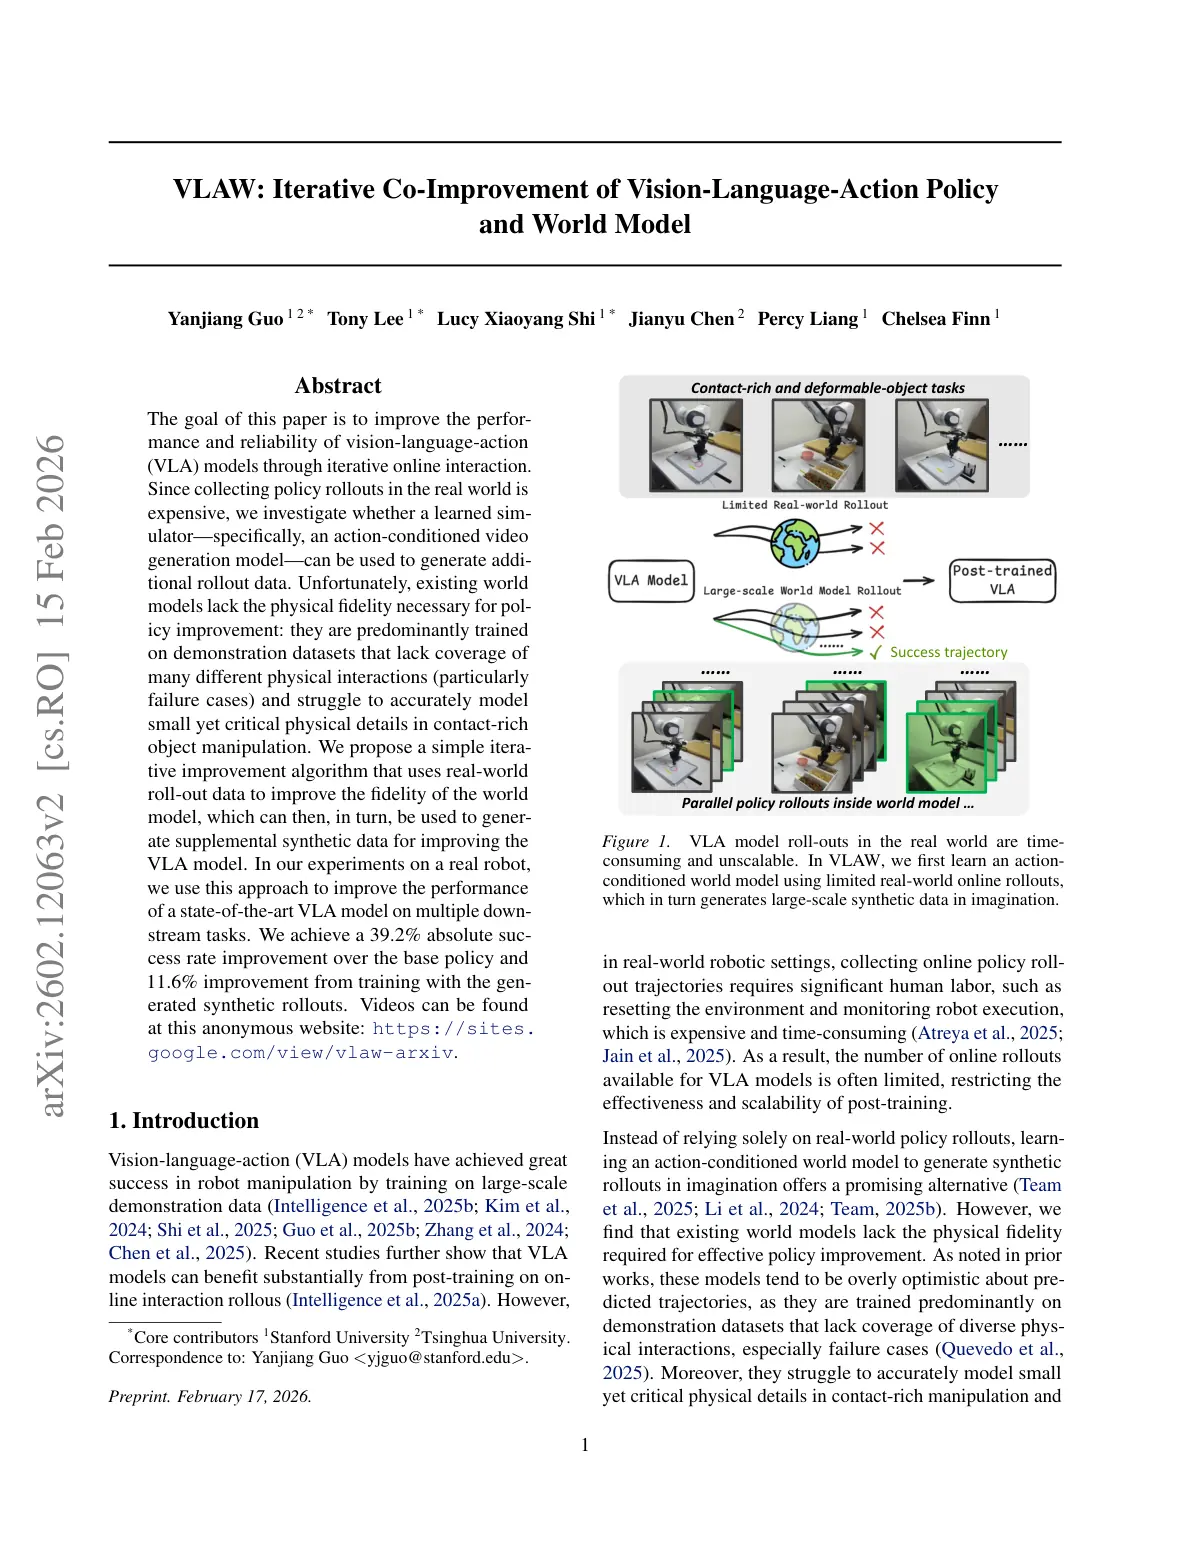
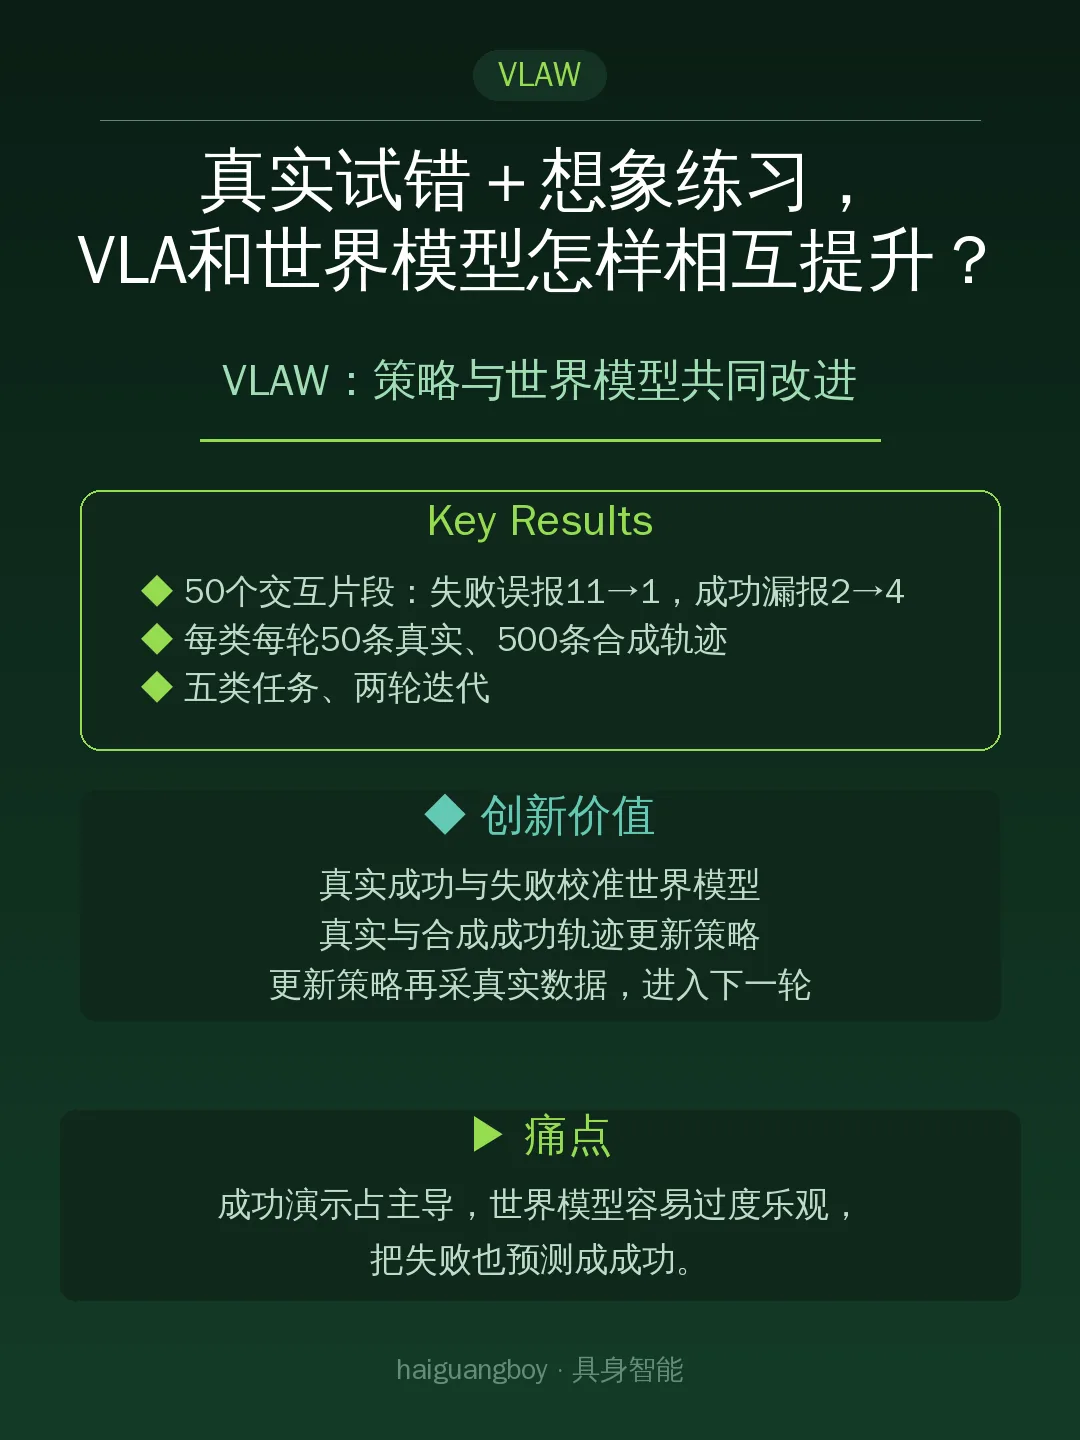
真机后训练贵在反复执行、复位和监控。让策略在世界模型里练习,能增加样本,但成功演示占主导的训练容易让模型过度乐观,把失败也预测成成功,接触和可变形物体任务尤其难。这样的想象数据,可能把策略教偏。
核心方法
真实执行校准想象,想象经验改进策略
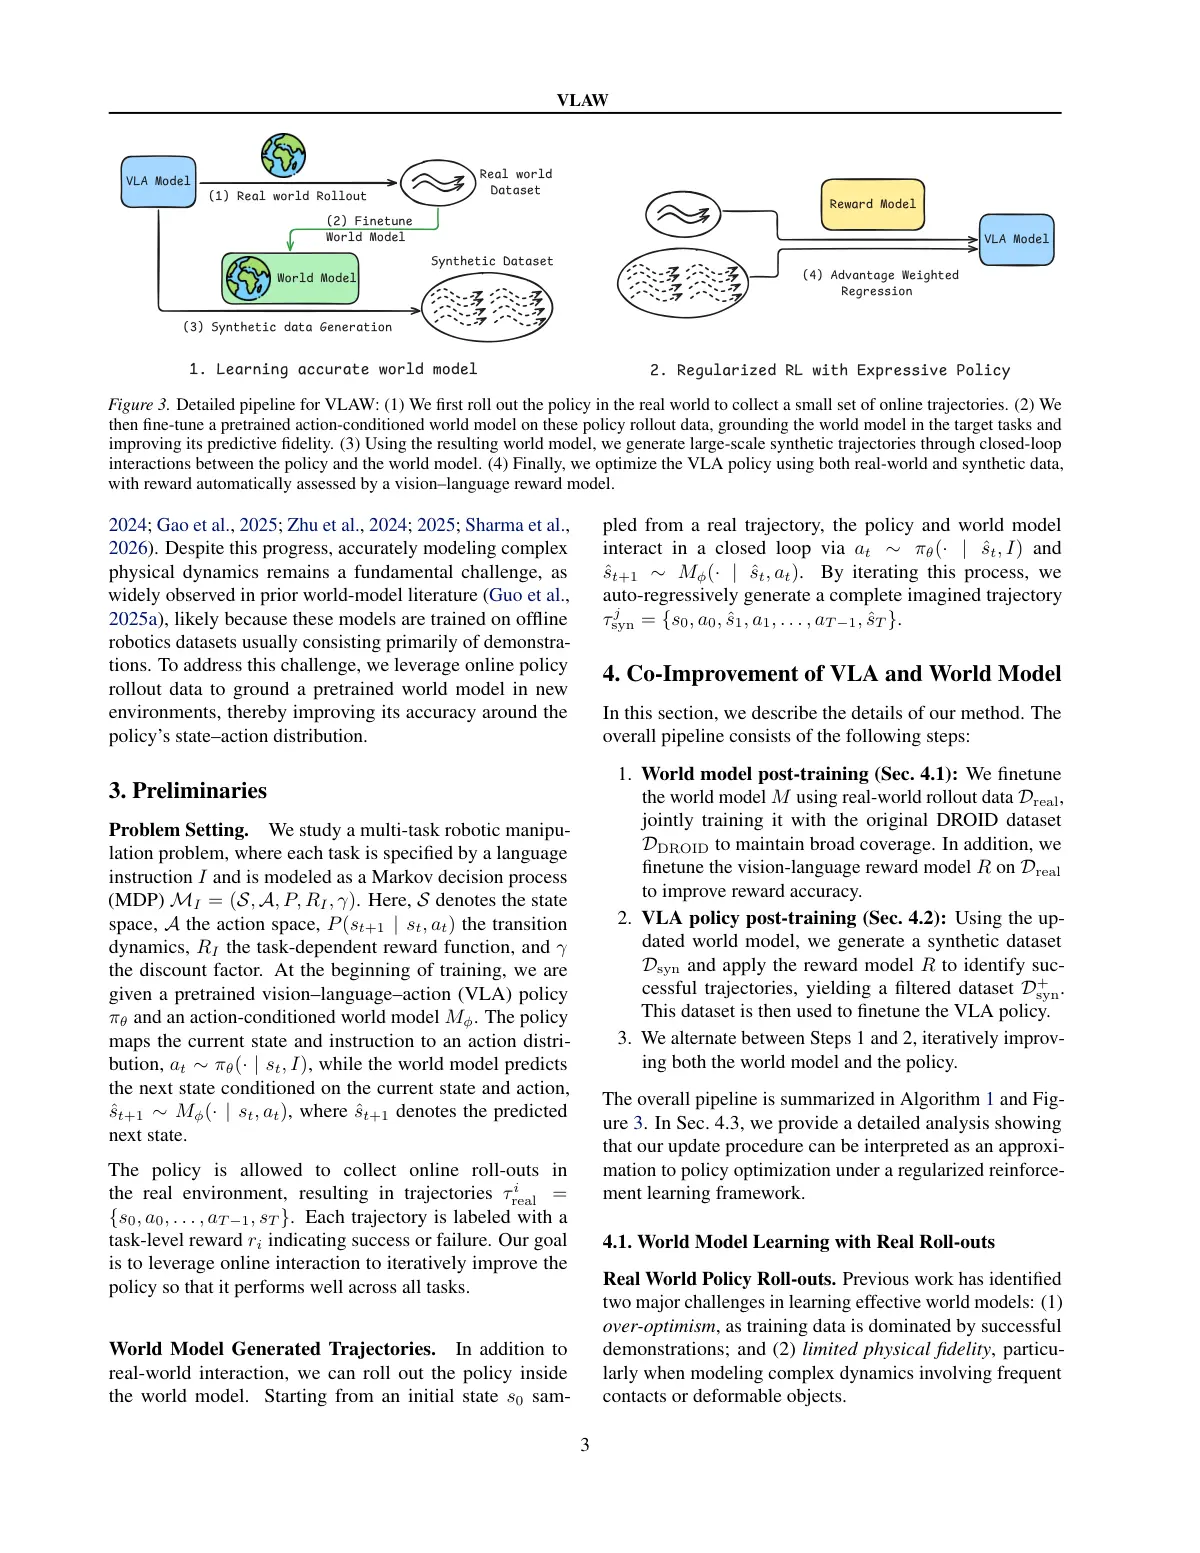
VLAW从π0.5和Ctrl-World出发,交替更新策略与世界模型。
↳ ① 真机执行校准世界模型。每类先用25条专家演示热启动策略;每轮每类收集50条真实轨迹,成功和失败都用于微调世界模型,同时混入原始DROID数据,防止过拟合。
↳ ② 在世界模型里生成更多练习。每轮每类生成500条合成轨迹,策略根据预测观测继续输出动作,形成闭环想象。用第一轮真实成功/失败标签微调Qwen3-VL-4B,再按“yes”概率阈值筛选;500条并非全部成功。
↳ ③ 策略只学成功,再回真机执行。真实成功轨迹与合成成功轨迹共同用于flow-matching训练,失败样本在策略损失中权重为0。更新后的策略再采集真实数据,进入下一轮。失败经验在这里主要通过校准世界模型间接帮助策略。
实验结果
· 相比仅用专家轨迹微调,加入在线数据后,在50个交互片段上,世界模型把失败预测成成功的次数从11降至1;把成功预测成失败的次数从2升至4,并非所有错误都下降。
· 相同真机交互预算下,VLAW比Filtered BC和DSRL获得更大的成功率提升。
· 画圆任务中,合成轨迹从500减到250,或去掉真实成功轨迹,性能都会下降。
这篇论文不是什么
⚠️ 边界
只验证了五类任务、两轮迭代,仍需人工复位和成功标注。加入在线数据同时改变了数据量、状态覆盖和失败样本构成,尚未单独隔离失败样本的因果贡献。
对机器人 / 世界模型 / VLA 的启发
💡 和WAM综述放在一起看
综述提醒:世界模型追求预测准确,策略追求回报,两者目标不同。VLAW把分工落到数据上:世界模型学习成功与失败,策略学习筛选后的成功经验。共同改进,不要求两者学习相同的轨迹集合。
半年后回看:在同等真机预算下,扩展任务与迭代轮次后,这种交替改进能否继续带来收益。
论文关键页