打开VLA黑箱:进度信号
一句话判断
打开VLA黑箱:进度信号
论文解决什么问题
VLA模型内部到底有没有"知道"自己任务做到哪一步了?这个问题不好回答——因为"模型表征了某个特征"这句话本身太模糊,从"能用探针读出相关信号"到"模型真的拿这个信号做决策",中间跨度很大,混着说容易得出似是而非的结论。
核心方法
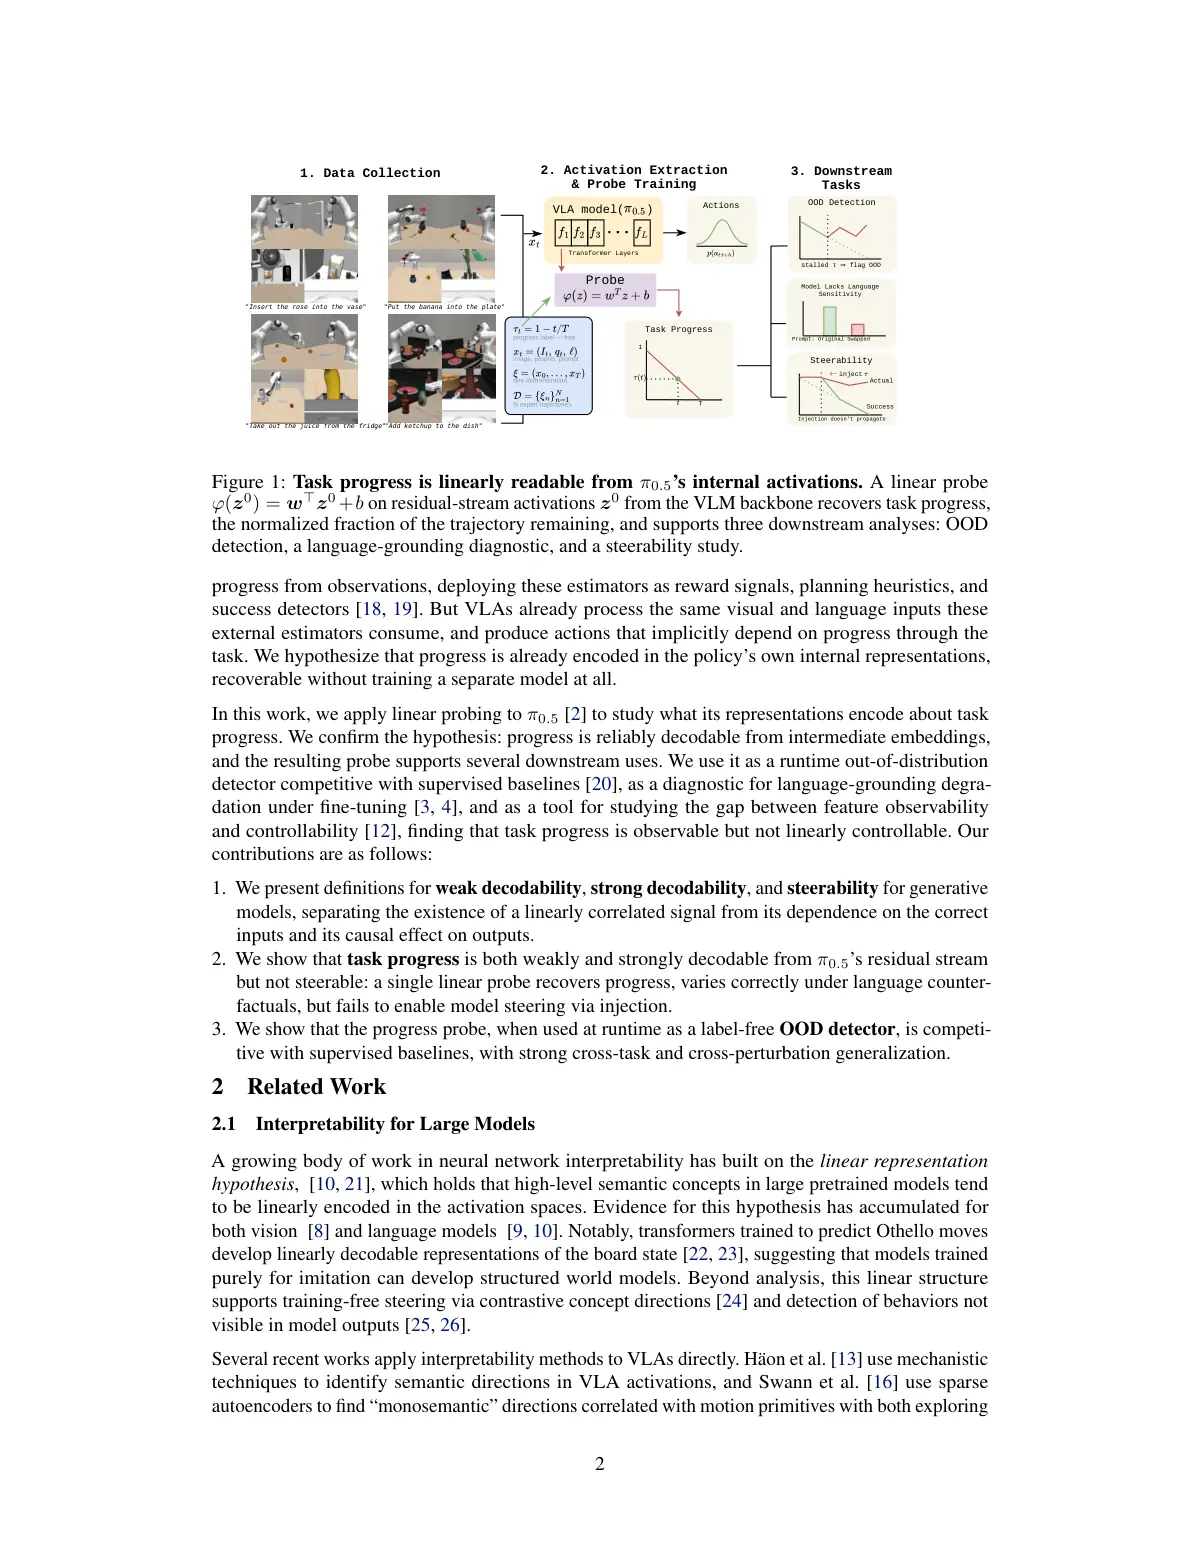
把"表征了"拆成三层,一层一层测任务进度这个信号
↳ 第一层,弱可解码——域内线性探针能不能读出信号。用这一层测任务进度(轨迹剩余时间的归一化占比),朴素探针域内拟合优度高达0.95,看起来漂亮过关
↳ 第二层,强可解码——换个反事实输入(把指令里"拿梨"换成"拿苹果"),同一个探针不重新训练依然要给出正确响应,排除"其实是走了视觉捷径"。第一层那个0.95的探针在这里现了原形:换个指令输出几乎不变,说明它压根没用语言输入,纯靠视觉蒙对;重新用对比目标训练后能修好这个问题,但代价是域内拟合优度跌到0.33——语言敏感度不是白拿的
↳ 第三层,可操控——直接在激活值上干预注入目标进度值,检验模型输出的动作是否真的按这个方向改变。哪怕拿到了修好的强可解码探针,注入"已经推进0.2进度"的偏移,模型后续层的读数照样没跟着变,生成的动作也没往对的方向靠——前两层都过关的信号,在这一层彻底失守
实验结果
· 进度特征在四个对比模型里,三个π系列变体表现相近且明显优于纯视觉语言骨干——说明这个特征是大规模机器人预训练建立起来的,不是任务微调塑造的
· 要让探针对语言反事实敏感,得在更深层用对比目标重训,代价是域内拟合优度从0.95跌到0.33——语言敏感度不是免费获得的
· 把这个探针直接当无监督OOD检测器用,效果能追平甚至反超需要专门OOD标签训练的监督式基线,面对训练时完全没见过的扰动类型时反而更稳健
这篇论文不是什么
· 全部实验只用了一个模型家族、只在仿真里做,能不能迁移到其他VLA架构或真实机器人还是开放问题
· 进度的真值标签是成功演示里的时间占比,把"时间流逝"和"任务真正推进"混在了一起
· "不可操控"这个结论只测了单一层、单一方向、固定幅度的一种干预方式,作者明确说更强或联合编辑多处的干预可能会有不同结果
对机器人 / 世界模型 / VLA 的启发
"读得出来不等于真被用来做决策"这个判断,和已经解读过的几篇工作反复印证:What/Where/How发现视频模型能把相机运动组织成连贯的几何轨迹,却学不到真正的物理推理;Blind Dexterity发现把状态估计器的预测接回观测对控制没有稳定收益,但估计器本身的误差确实在接触后系统性下降,证明信息真实存在。三篇论文从三个不同角度撞上了同一堵墙:一个信号能被稳定读出,不代表它是模型用来行动的那个变量。
论文关键页