想要VLA更可靠,代价是更多重规划吗?
一句话判断
想要VLA更可靠,代价是更多重规划吗?
论文解决什么问题
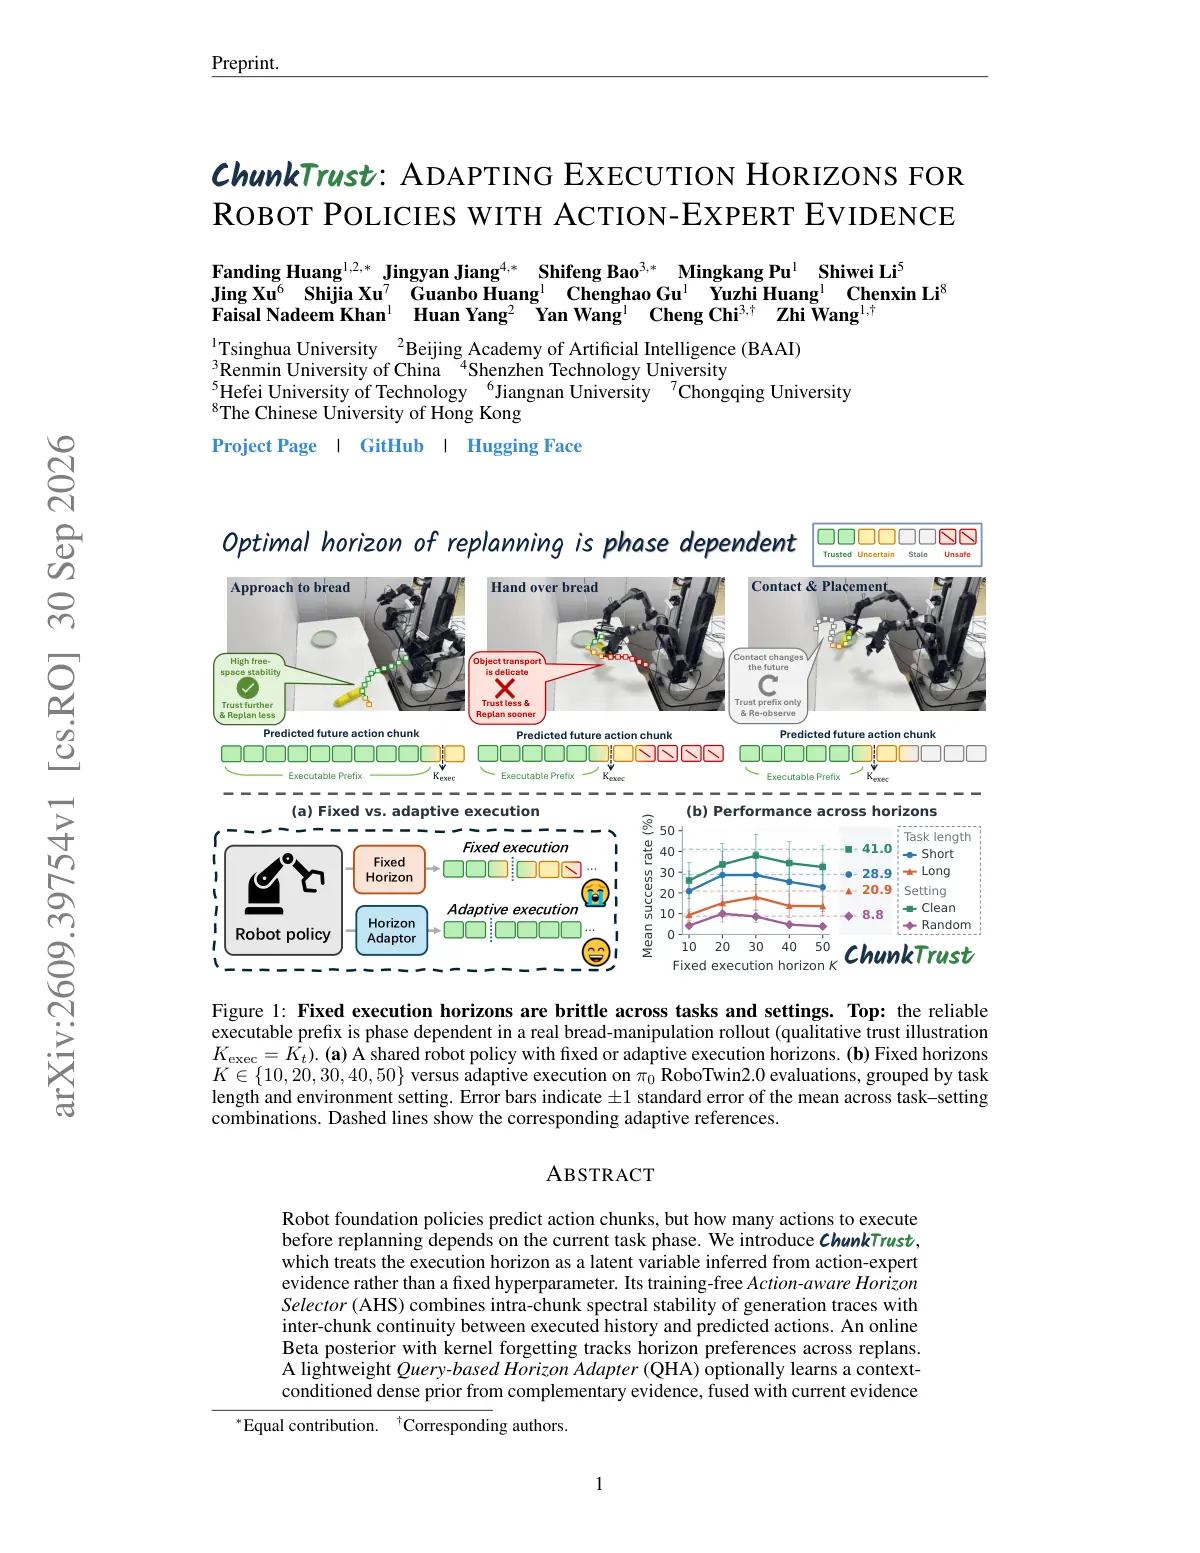
同一个VLA checkpoint,执行方式也会影响结果。动作块能摊薄推理成本,却让机器人在两次观察之间依赖旧信息。执行太久,接触变化后纠错不及时;重规划太频繁,又可能打断运动、增加计算。
ChunkTrust关注的不是“调用越多越好”,而是当前动作块该执行多少步再重新观察,让执行长度随阶段相关证据变化。
核心方法
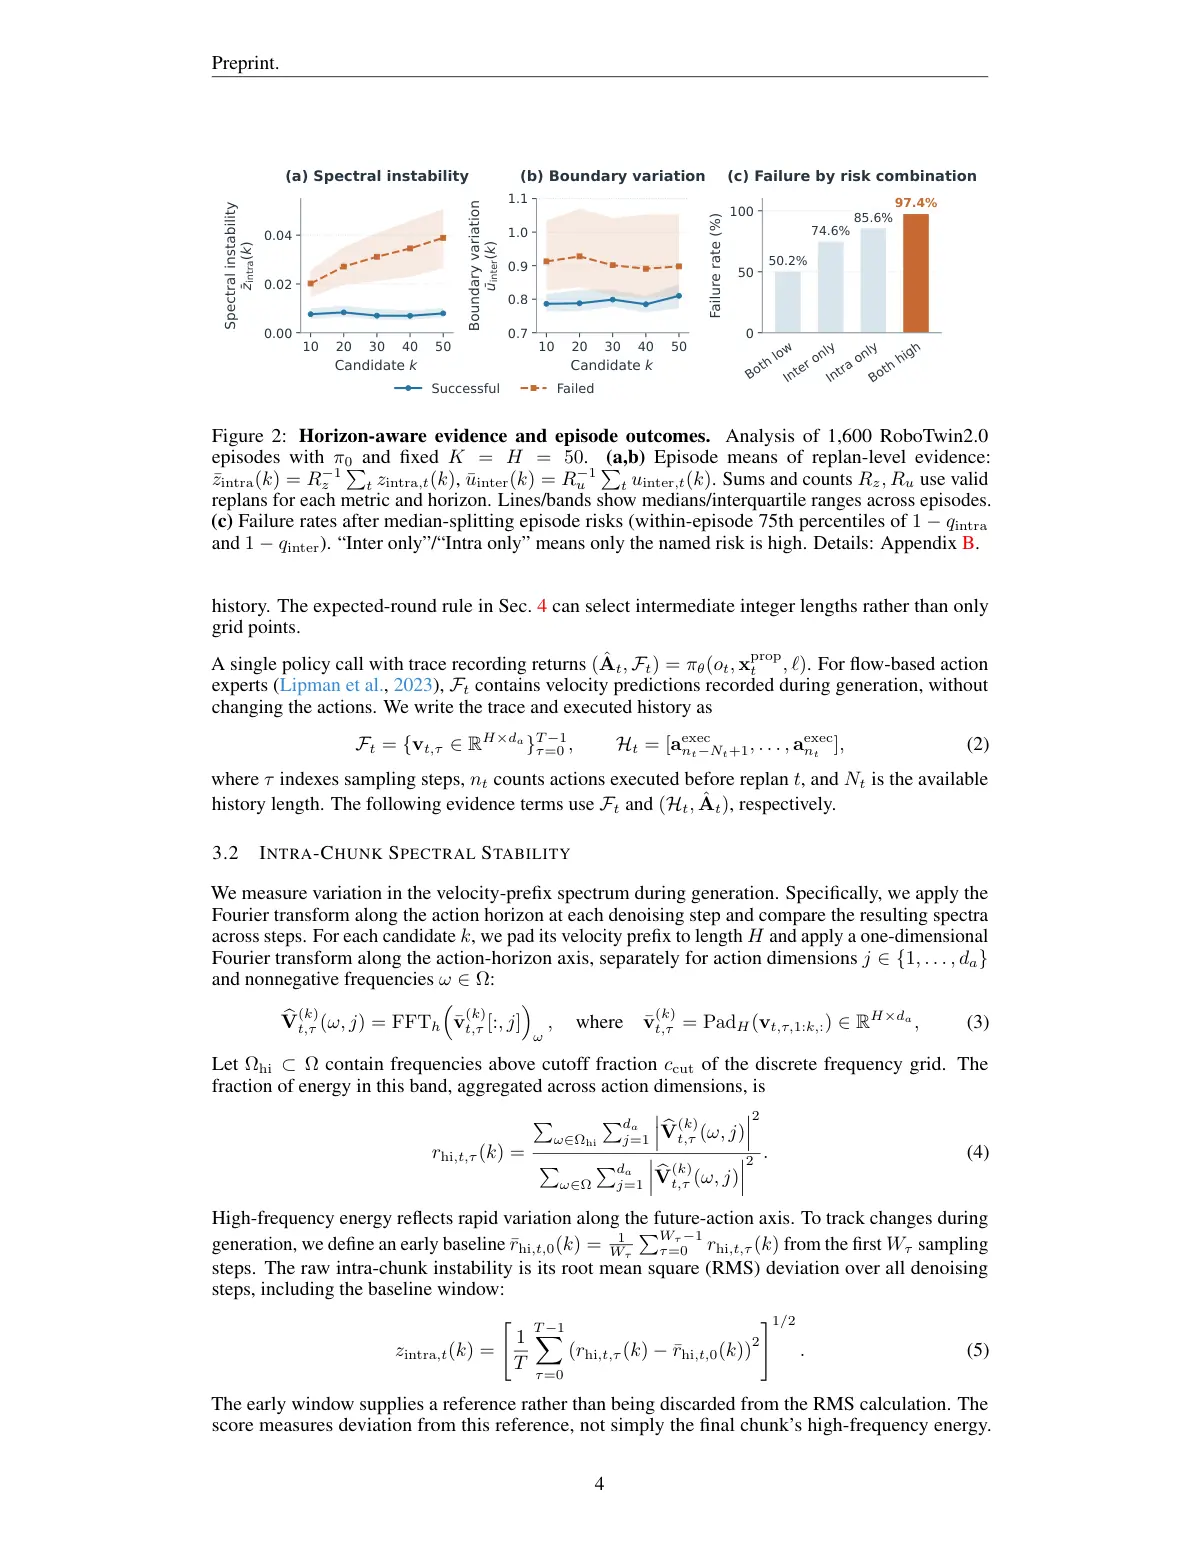
无需训练的AHS保留基座权重和动作值,评估候选前缀的两类证据:
↳ 块内:flow生成过程中,频谱相对早期去噪基线是否稳定。
↳ 块间:接到已执行动作后,速度是否不规则。独立看很稳定的预测,也可能接不上历史运动。
带遗忘的Beta状态积累回合内长度偏好,缓解单次证据噪声;每局重置。可选QHA离线学习条件先验,部署时不在线更新。
实验结果
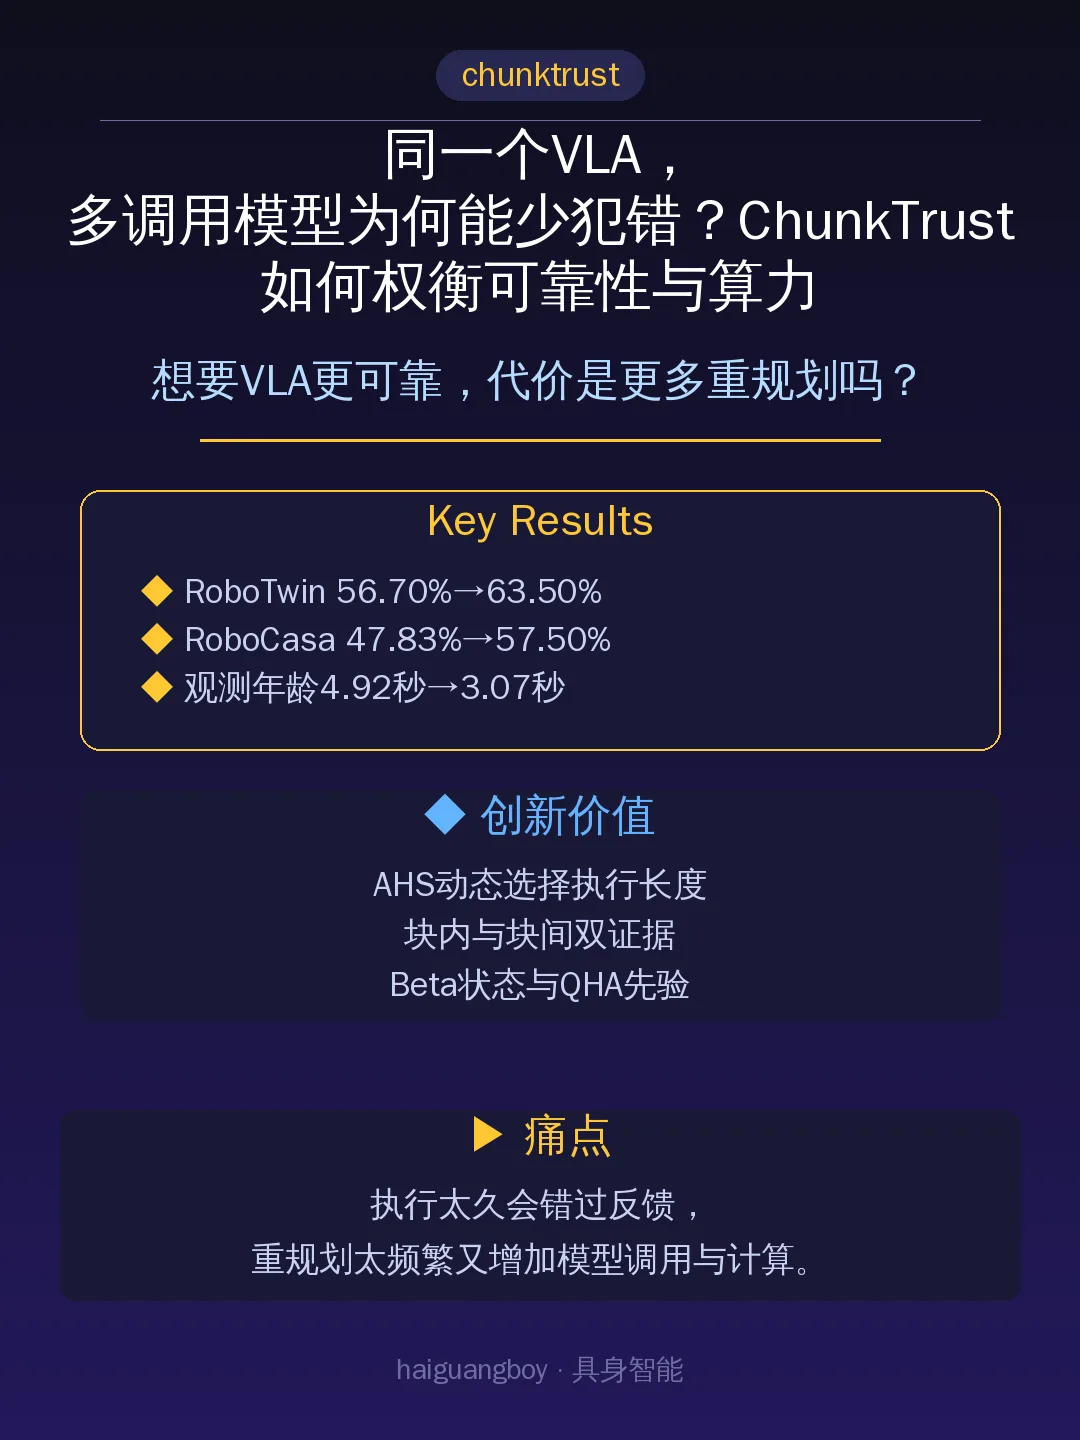
· RoboTwin完整50任务,同一π0.5成功率56.70%→63.50%。
· RoboCasa24任务,Qwen3GR00T为47.83%→57.50%;独立八任务Fast-WAM评测组为86.81%→88.13%。
· 真机四任务各15次,归一化过程得分50.4%→57.5%,不是完整成功率。
这篇论文不是什么
⚠️ 平衡不等于最优,更不是安全保证
内部质量与Beta状态不是校准成功概率。选定前缀执行期间没有新观测监控,突发扰动仍需其他机制。QHA存在任务回退;上述延迟实验使用受控时钟,不能直接当作原生部署耗时。选择器开销小,也不代表整局更省算力。
对机器人 / 世界模型 / VLA 的启发
💡 放到执行层的技术脉络里
Legato通过训练改善动作块衔接;SmoothRL学习残差修正执行动作;ChunkTrust保留动作值,调整重新获取反馈的时机。
三者处理不同环节。判断执行方案是否值得部署,应把成功率、反馈时效、模型调用与总计算一起看,而不是只报选择器的毫秒开销。
论文关键页