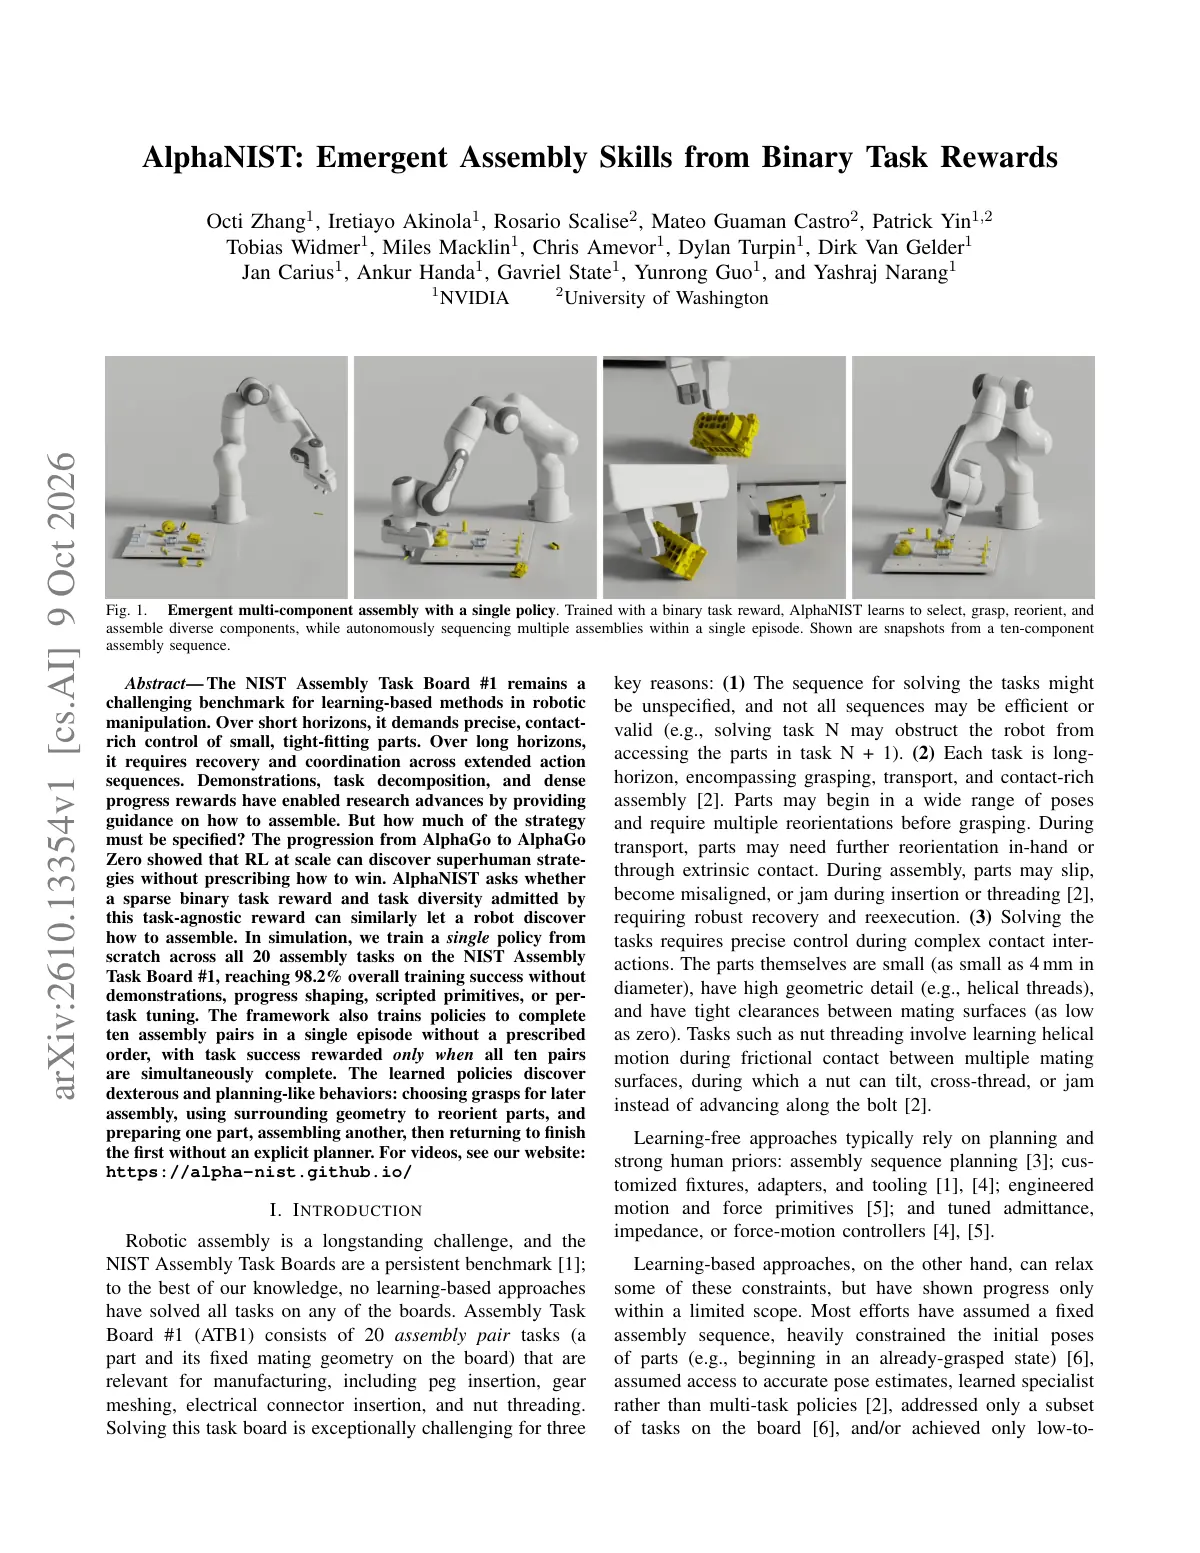
不教步骤,装配技能如何从奖励中涌现?
一句话判断
不教步骤,装配技能如何从奖励中涌现?
论文解决什么问题
随机初态下,M4螺母、4mm插销和杆件插入的独立策略成功率不超过0.3%,主要卡在抓取。AlphaNIST把20类装配交给共享策略训练,却出现了成功抓取并装配的轨迹。
这体现了跨任务正迁移:不同任务的经验,可能帮助策略突破单任务探索的瓶颈。但具体技能如何迁移,尚未被逐项隔离验证。
核心方法
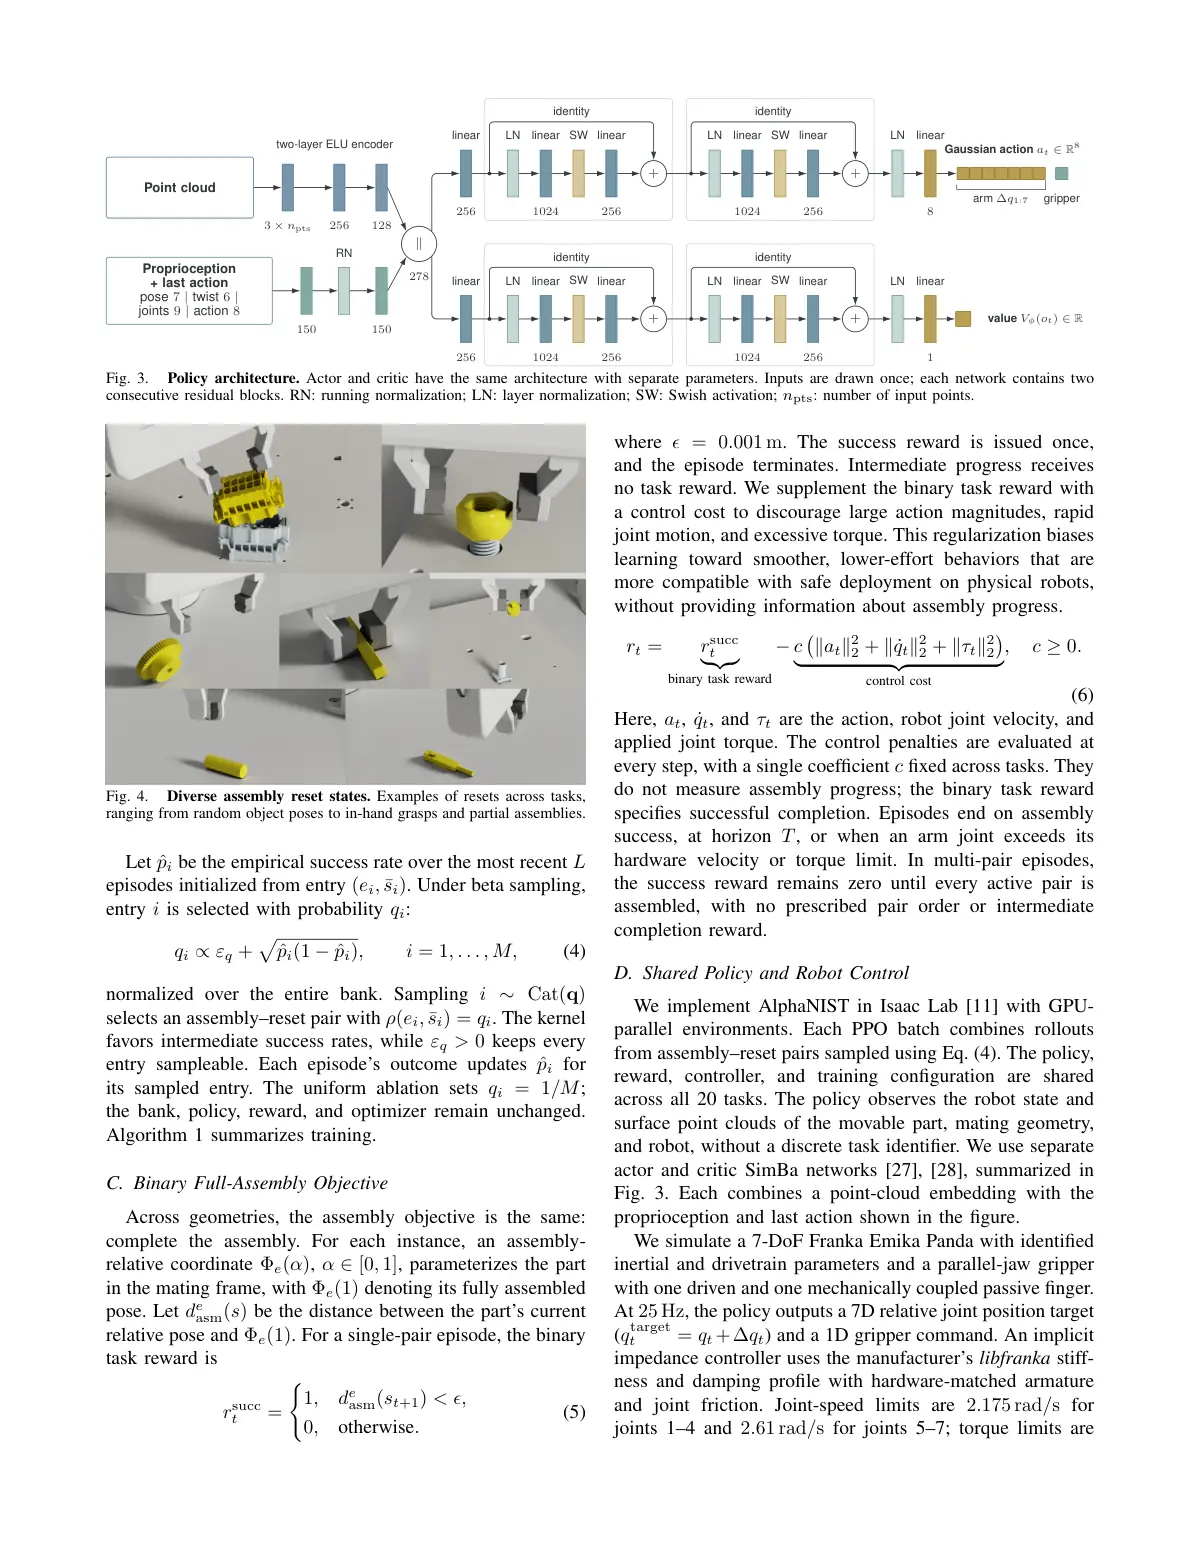
一个共享PPO策略,根据零件与配合几何的表面点云、机器人状态和上一动作,输出关节目标与夹爪指令。
没有专家示范、预设动作原语或逐任务调参。完成装配才给任务成功奖励,中间不奖励靠近、对齐;每步仍保留动作、速度和力矩代价。
不同几何共享完整装配目标,让策略有空间寻找各自有效的操作方法。
实验结果
↳ 放下零件重新抓,露出更多插入端。
↳ 借板面接触调整零件朝向。
↳ 先暂存USB-A,完成杆件后再返回插接。
这些技巧没有被专项奖励逐项指定。连续装配也没有显式规划器规定顺序;10对全部完成,才获得一次任务成功奖励。
这篇论文不是什么
⚠️ 无示范,不等于没有探索支撑
缓存初态覆盖散放、在手、搬运和部分装配;成功引导采样优先练习中等难度条目。保持二元目标,改用均匀采样,评测从97.4%降至84.3%。
全部结果来自仿真,98.2%不能当工业可靠率;覆盖20类任务,也不等于一次完成整块20件装配板。
对机器人 / 世界模型 / VLA 的启发
💡 多样性如何转化为能力?
本篇支持的是:共享目标、任务多样性、初态覆盖和经验分配共同作用,能让部分单练难例变得可解。
这还不是“任务越多越聪明”的scaling law。更值得检验的是:扩大任务集合后,正迁移能否持续,以及这些重抓、接触调整和协调行为能否迁移到真机。
论文关键页