VLA的数据源,VLM读不懂
一句话判断
VLM认物不认人的意图
论文解决什么问题
人类第一视角视频正在变成VLA扩规模的重要数据源——这个频道已经看过好几个例子:MINT从普通第一视角视频里恢复运动监督,NVIDIA GR00T靠2万小时EgoScale视频训出灵巧度scaling law,Figure Index、Skild的数据引擎也都把第一视角人类视频当核心来源之一。但这篇综述系统梳理下来发现,通用视觉语言模型本身在第一视角视频上远没有过关——认得出画面里有什么物体,却读不懂交互和动作是怎么随时间演变的,更别提猜到人真正想干什么。如果VLA继续靠这类数据扩规模,这个短板很可能被直接带进下游的机器人策略里。
核心方法
把散落的失效原因归纳成四类,最后收束成同一个根本问题
↳ 四类失效原因:弱交互理解(认物体74.33%,认动作只有46.61%);弱时间推理(长时程基准得分接近随机水平);物体歧义(小/遮挡/手持物体难和施动的手绑定);运动噪声(自我运动破坏密集时空特征)
↳ 时间推理改训练目标就能解决,不用堆规模:对比有序/打乱帧顺序的训练方法,把3B模型的得分从20.4%拉到49.7%,反超规模大得多的基线
↳ 自我运动是个双刃剑:既要压制(稳定化裁剪+17-22%),又能利用(IMU重建特征省约200倍计算)——第三人称模型从没学过处理这种二重性
实验结果
· 综述把这四类分散的失效原因收束成同一句判断:现有模型把第一视角视频当成一袋帧和物体处理,而真正的信号本质上是随时间展开的关系
· 五个主要数据集在互补的设计空间里各占一角,没有一个能单独覆盖所有需求
· 即便标注最全的数据集也存在系统性地理文化偏差,覆盖最广的那个也只集中在城市和大学城
这篇论文不是什么
· 文中引用的具体数字都来自被综述的原论文,这篇综述本身没有跑新实验,贡献在于组织诊断框架和串联视角
· 标准化采集平台虽然统一了模态标准,但集中用同一套硬件可能引入新的传感器特有偏差,作者明确说这还是未解决的问题
对机器人 / 世界模型 / VLA 的启发
这篇综述最有意思的地方,是它的核心论点——"关系结构比孤立的帧和物体更重要"——被这个频道已经独立解读过的好几篇论文各自撞上了同一堵墙:MINT发现手部运动天然和相机运动、场景几何耦合在一起,不该拆成独立问题分别处理;TacWAM发现触觉的时间歧义是结构性的,不是采样率不够;What/Where/How发现视频模型能把相机运动组织成连贯几何,却学不到真正的物理推理;HyperWorld证明把高阶联合结构硬拆成二元组会打散信息,超图式的联合表示才是自然匹配。四篇论文,四个完全不同的具体问题,各自独立撞上了同一个更大的判断——这篇综述算是把这条散落各处的线,第一次正式串起来讲清楚了。
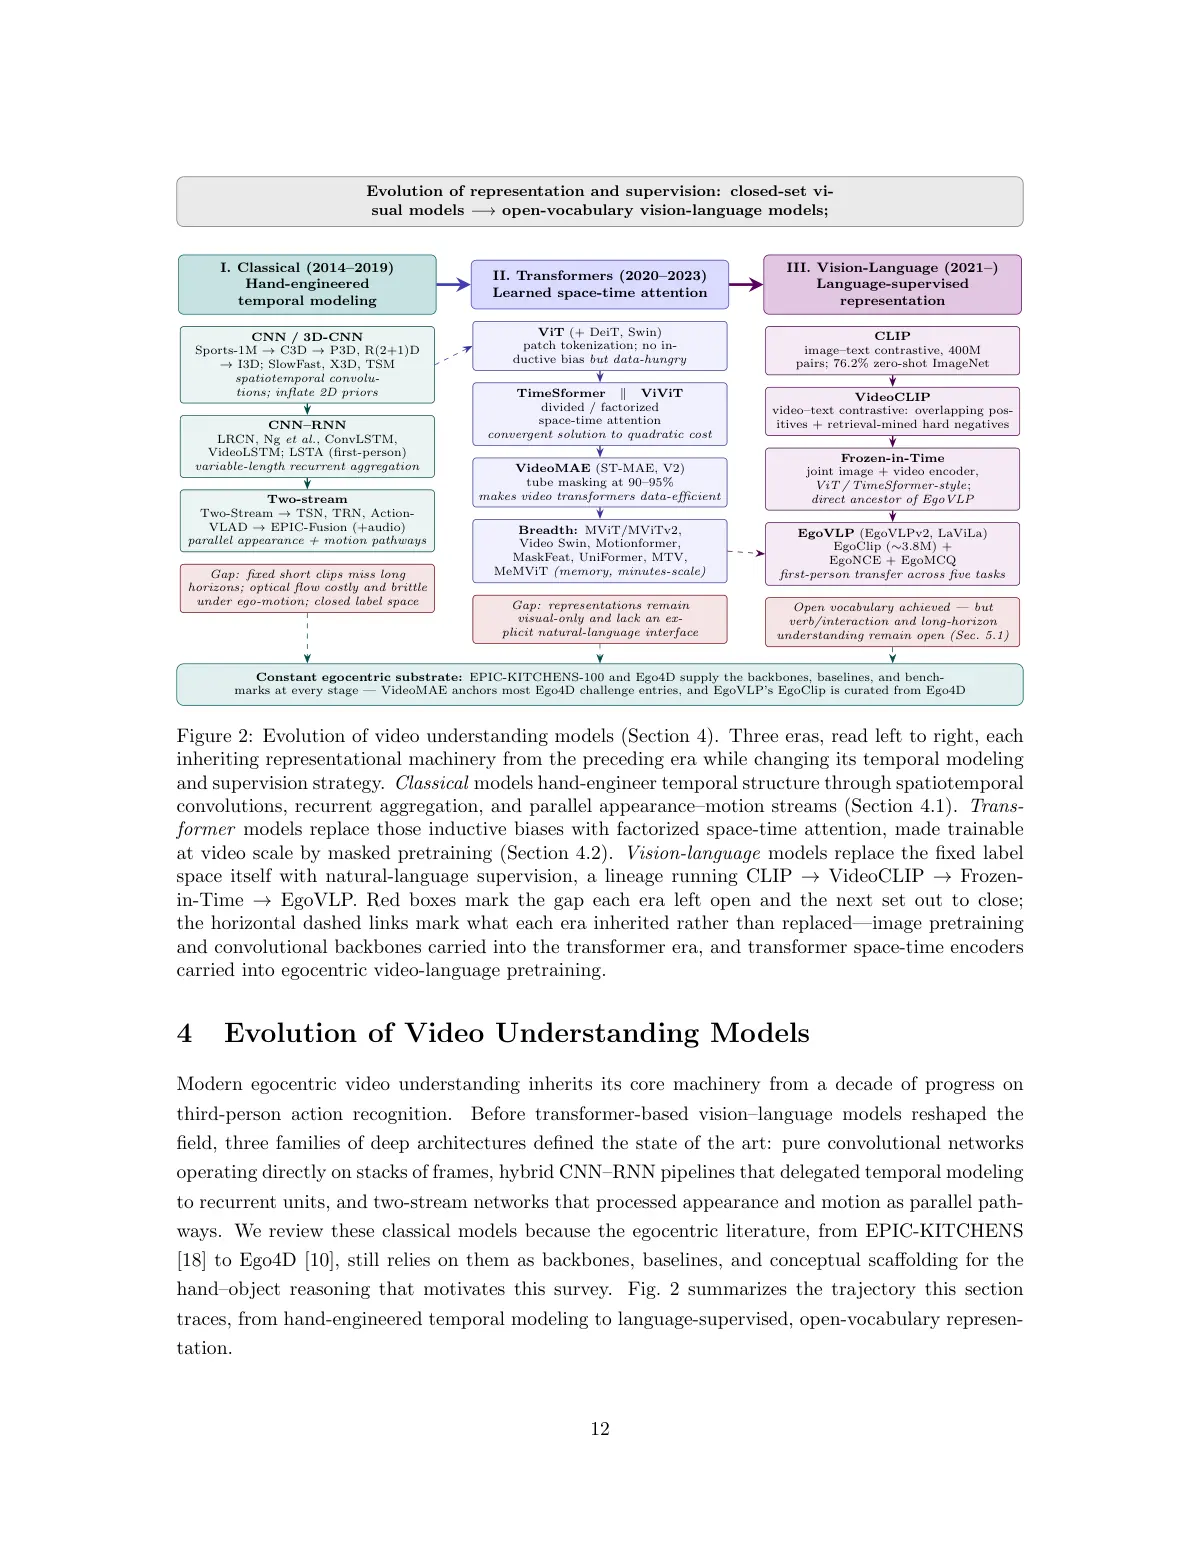
论文关键页