MoCaP:人类视频驱动零样本移动操作
一句话判断
MoCaP:人类视频驱动零样本移动操作
论文解决什么问题
人类日常活动录像记录了丰富的环境与交互经验,机器人要复用它们,却面临两道难题:非结构化录像里的地点、物体与交互信息,需要先被提取出来;人的身体与机器人不同,人能完成的动作也不能直接照搬。如何利用已有录像完成新任务,减少对逐任务专门示范的依赖,是MoCaP要解决的问题。
核心方法
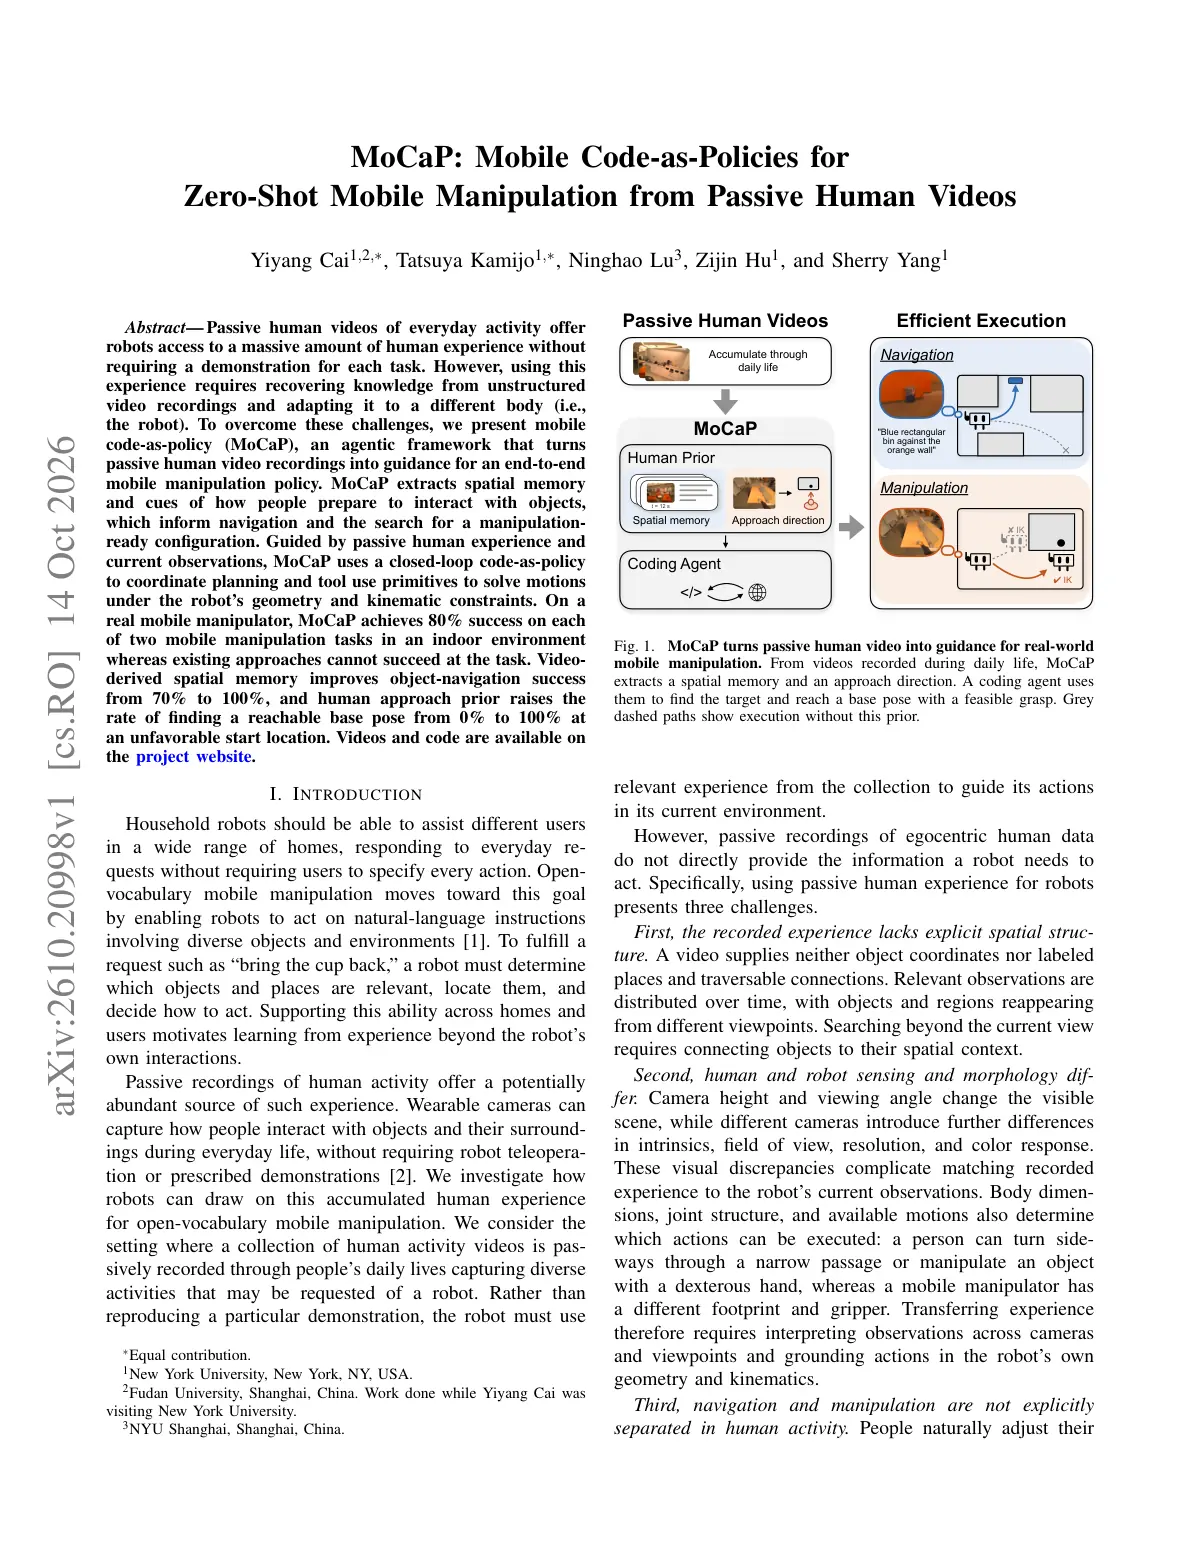
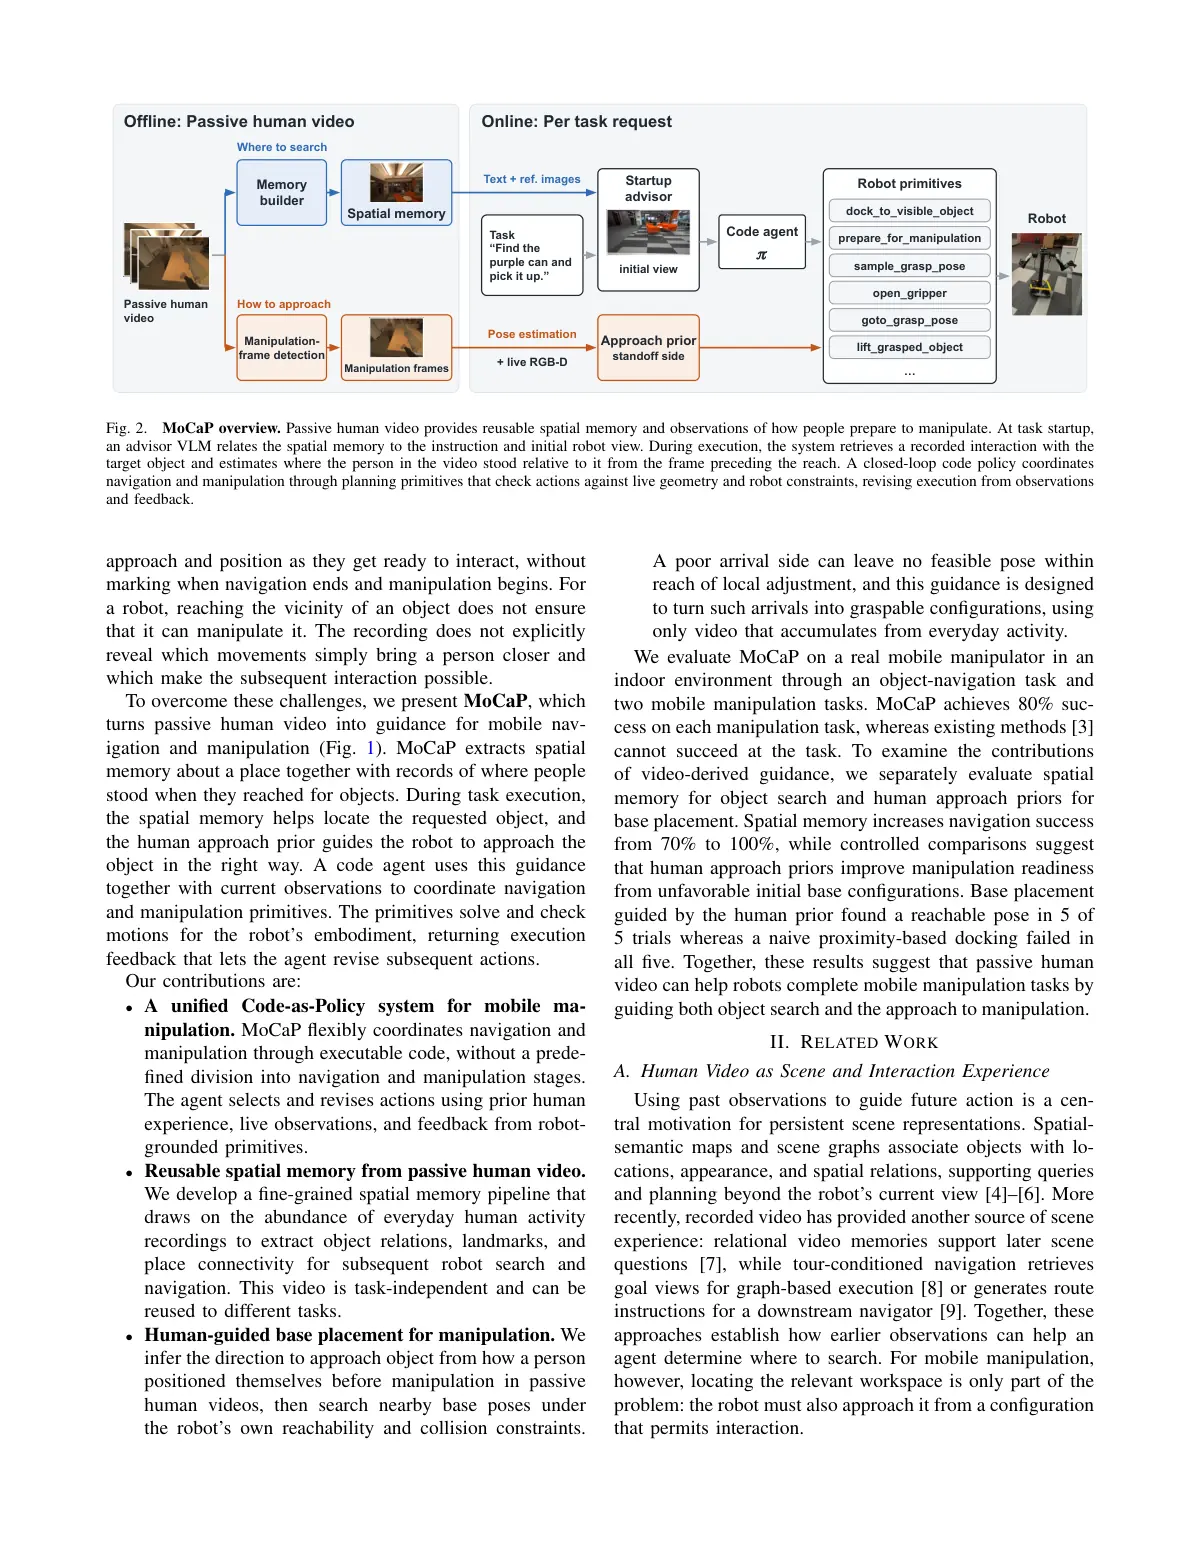
MoCaP把日常视频整理成可复用的场景记忆与接近先验,再由闭环代码代理结合实时观察,调用导航、规划和抓取工具。全部学习组件冻结,不做任务专门训练,重点在于把人类经验接到机器人的执行约束上。
↳ ① 从日常录像中提取“去哪找”
在收到下游指令前,系统先整理视频里的地点、物体、连接关系和参考画面,形成可跨任务复用的场景记忆。任务启动时,顾问结合记忆、指令和机器人初始视图,给出可能位置和导航子目标。
↳ ② 从人类交互中提取“从哪边接近”
录像还保留人伸手前的准备线索。机器人借用接近方向,结合实时深度对齐几何尺度,再按自身尺寸和运动学选择停靠距离,搜索附近底盘位置与朝向。人类经验提供方向,具体站位由机器人约束决定。
↳ ③ 用闭环代码把经验接到动作上
代码代理根据观察生成短Python程序,调用Nav2和抓取原语。底盘调整后重新感知,再由cuRobo规划全臂运动;调用失败就中断后续程序,把诊断返回代理,修订下一步。导航、站位和抓取由反馈串起来。
实验结果
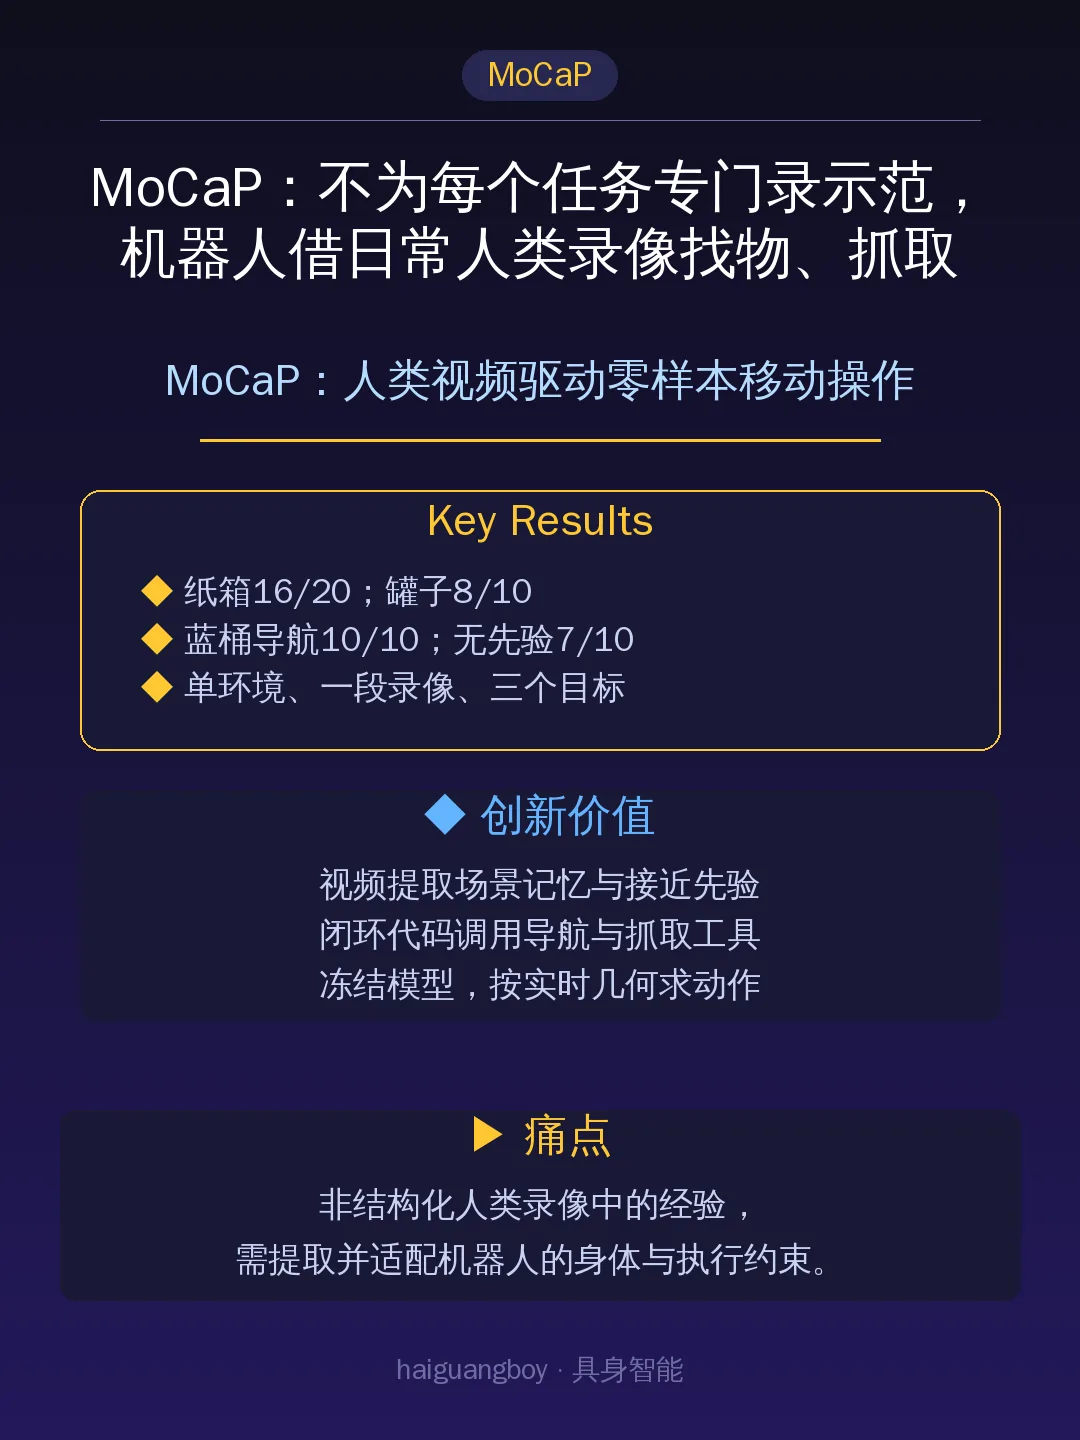
纸箱完整抓持16/20,罐子8/10,两项均为80%;蓝垃圾桶导航为10/10,无视频先验变体为7/10。抓持成功要求抓起指定物体并稳定持有。
两条抓取基线均未成功,但抓取与规划后端也不同,不能把全部差距归因于视频经验。
这篇论文不是什么
⚠️ 代价与边界
评测只覆盖一个环境、一段录像和三个目标,操作主要是抓取、抬起。零样本仍需要标定、实时深度、运动学及现成模型。原文部分试验次数表述冲突,准备度检查也不能当作实际抓持成功率。
对机器人 / 世界模型 / VLA 的启发
💡 工程启发
人类视频的用途,可以延伸到执行时直接调用的记忆与接近经验。这与《Towards Agentic Robots》讨论的执行器启动条件相呼应:选对技能,还得把机器人送到技能能执行的状态。
MoCaP展示了一条不更新模型权重的经验复用路径。它能否扩展,仍要看换环境、换录像、统一后端后,完整操作成功率是否稳定受益。
论文关键页